T1#research
Med-PaLM ── 医師国家試験形式の問題で合格ラインを越えた言語モデル
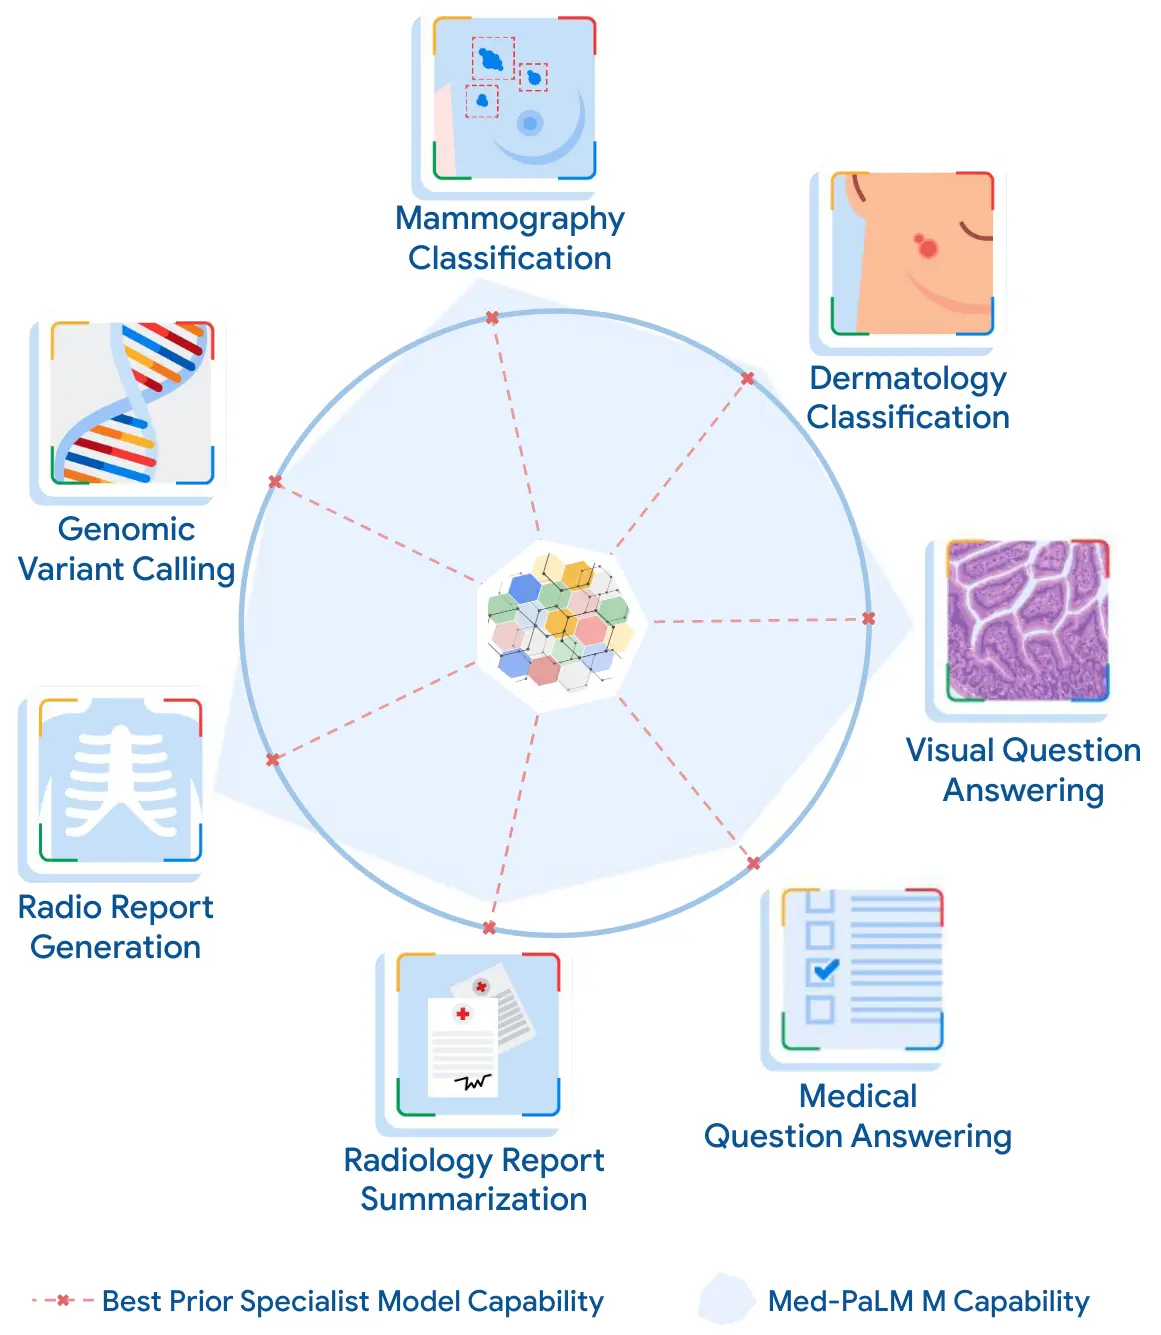
Med-PaLM は、Google Research と DeepMind の研究者が作った医療向けの 大規模言語モデル である。2022年12月26日に論文「Large Language Models Encode Clinical Knowledge」が arXiv で公開され、2023年7月12日に Nature に掲載された。米国医師国家試験(USMLE)形式の問題を集めた MedQA で、Google が合格ラインとする60%を越えたことから、AI が医師国家試験に合格した最初の例として紹介されることが多い。Google 自身の言い方は、USMLE 形式の問題で合格ライン(60%超)を初めて越えた AI システム、である。実際の試験を受けたわけではなく、試験形式の問題集での評価である点には注意したい。
ChatGPT の公開から1か月足らずの時期で、言語モデルを医療に使えるかという問いが一気に現実味を帯びた。この論文はその問いに、成績と同時に「まだ臨床医には及ばない」という答えを出している。
何をしたのか
出発点は、Google の5400億パラメータの言語モデル PaLM と、それを多数の指示で調整した Flan-PaLM である。研究チームはまず、医療の質問応答を測る評価セット MultiMedQA をまとめた。医師国家試験形式の MedQA、インドの医学部入試の問題を集めた MedMCQA、論文の要旨から答える PubMedQA、MMLU の臨床分野など既存の6つのデータセットに、ネットで実際に検索される健康の質問を集めた新しい HealthSearchQA を加えたものである。
プロンプト の工夫を組み合わせた Flan-PaLM は、多肢選択の各データセットで当時の最高成績を出し、MedQA では67.6%と、それまでの最高を17ポイント以上上回った。しかし医師が長い回答を読んで評価すると、大きな欠点が見えた。そこでチームは、臨床医が作った少数の手本を使ってモデルを医療向けに合わせる 指示プロンプト調整(instruction prompt tuning) を考案した。モデル本体を作り直すのではなく、少数のパラメータだけを学習させる軽い 調整 で、こうしてできたのが Med-PaLM である。
医師による評価
Nature 版の論文によると、消費者の医療の質問140問について、米国・英国・インドの9人の臨床医のパネルが、出所を伏せて回答を評価した(1つの回答を1人が評価)。
| 評価項目 | Flan-PaLM | Med-PaLM | 臨床医の回答 |
|---|---|---|---|
| 科学的コンセンサスと一致 | 61.9% | 92.6% | 92.9% |
| 有害な結果につながりうる | 29.7% | 5.9% | 5.7% |
この2項目では Med-PaLM は臨床医とほぼ並んだ。ただし論文の結論は、Med-PaLM は有望だが「なお臨床医に劣る」というものだった。一般の人による評価でも、Med-PaLM の回答は Flan-PaLM より質問の意図に沿い役に立つとされたが、臨床医の回答には及ばなかった。
Med-PaLM 2 ── 86.5%
Google は2023年3月の年次イベント The Check Up で Med-PaLM 2 を発表し、5月16日に論文を arXiv に出した。基盤を PaLM 2 に替え、医療向けの追加学習と、複数の推論をまとめ直す「アンサンブル精緻化」などの手法を組み合わせている。
| Med-PaLM | Med-PaLM 2 | |
|---|---|---|
| 最初の公開 | 2022年12月26日(arXiv) | 2023年3月発表、5月16日 arXiv |
| 査読誌 | Nature(2023年7月12日) | Nature Medicine(2025年1月8日) |
| MedQA の正答率 | 67.2% | 最大86.5% |
| 医師との比較 | なお臨床医に劣る | 1066問の比較で9軸中8軸で医師の回答より好まれた |
Med-PaLM の67.2%は、Med-PaLM 2 の論文に書かれた数字である。最初の論文の要旨にある67.6%は、Med-PaLM の元になった Flan-PaLM の成績で、2つは別のモデルの数字だ。
2025年の Nature Medicine 版は、実際の医療の質問を使った試験的な評価も載せている。専門医は、一般医の回答よりも Med-PaLM 2 の回答を65%の割合で好んだ。ただし専門医自身の回答のほうが全体としては好まれ、安全性については専門医も一般医も Med-PaLM 2 を医師の回答と同程度と評価した。Google はその後、Med-PaLM 2 を、Google Cloud の顧客向けの医療用モデル群 MedLM を支える研究モデルの一つとしている。2023年7月には、画像やゲノムも扱う多モーダル版 Med-PaLM M の研究も発表された(上の図)。
同じ時期のほかのモデル
試験形式の問題での成績は、すぐに他社のモデルにも追いつかれた。Nori らは2023年3月20日、医療向けの特別な調整をしていない OpenAI の GPT-4 が、特別なプロンプトの工夫なしで USMLE の合格点を20ポイント以上上回り、Med-PaLM も上回ったと報告した。
日本の医師国家試験については、Kasai らが2023年3月31日に、GPT-4 が評価した6年分の試験すべてで合格水準に達したと報告している。同じ論文は、日本の医療で厳に避けるべき選択肢、たとえば安楽死を示唆する選択肢を選ぶことがあったこと、日本語は文字の分割のされ方のために API の費用が高く、扱える文脈も短くなることを限界として指摘した。
著者らが挙げた限界
Med-PaLM の論文は、限界を独立した節で詳しく論じている。主なものは次のとおりである。
- 多肢選択の問題は、専門家が作った症例文に基づき、おおむね正解が一つに決まるよう選ばれている。患者から情報を引き出し、所見をまとめて方針を立てる実際の診療より本質的に易しい
- 評価は英語のデータだけで、多言語での評価が急務である
- 人による評価の軸は網羅的ではなく主観的で、回答1つを1人が評価しただけである。評価者の数と多様性を大きく増やす必要がある
- 医学的コンセンサスは時代とともに変わり、人種・性別・年齢などによる差別の影響を受けてきた。モデルは学習時点のコンセンサスを反映しうる
- 臨床に使うには、権威ある医療情報源に基づいて答えること、不確かさを伝えること、医療の安全要件に合わせることなどの能力がさらに必要である
何が変わったか
Med-PaLM が示したのは、汎用の言語モデルを少ない手間で医療に合わせられること、そして試験の点数だけでは足りないということの両方だった。著者ら自身が、多肢選択の正答率と、医師が回答を読んだときの評価のあいだに大きな差があることを示し、評価の枠組みそのものを主要な貢献に挙げている。
利用の面では、HealthSearchQA が示すように、人々が検索エンジンに打ち込む健康の質問に言語モデルが答える時代が近づいていた。誤った回答が人を傷つけうることを、論文は「有害な結果につながりうる」割合として数値化した。一方、医療機器として当局の審査を経て使われる AI と、言語モデルの距離はなお大きい。審査を受けた例は IDx-DR や EndoBRAIN に、医療 AI が現場で期待を下回った例は Epic の敗血症予測モデル にある。
言語モデルが数学の問題で人間の上位層に並んだ例は 国際数学オリンピックでの金メダル水準 に、同じ時代の流れは AI の年表 と AI と社会の年表 にある。研究所については Google と DeepMind のページを参照のこと。
よくある質問
- Med-PaLM とは何ですか。
- Google Research と DeepMind の研究者が作った医療向けの大規模言語モデルです。5400億パラメータの PaLM を指示調整した Flan-PaLM を、少数の例を使う「指示プロンプト調整」で医療向けに合わせたもので、2022年12月26日に論文が arXiv に公開されました。
- 医師国家試験に合格したのですか。
- 実際の試験を受けたのではなく、米国医師国家試験(USMLE)形式の問題集 MedQA で評価されました。Google は、合格ライン(60%超)を初めて越えた AI システムだとしています。Med-PaLM 2 の論文によれば Med-PaLM の正答率は67.2%、Med-PaLM 2 は最大86.5%でした。
- 医師の代わりになるのですか。
- 著者ら自身が否定的です。医師による評価で Med-PaLM の回答はなお臨床医に劣るとされ、多肢選択問題は患者から情報を引き出して判断する実際の診療より易しいと書いています。Med-PaLM 2 でも、全体としては専門医の回答のほうが好まれました。
- 日本の医師国家試験ではどうでしたか。
- Med-PaLM 自体は日本語で評価されていません。別の研究者らが2023年3月に、OpenAI の GPT-4 が過去6年分の日本の医師国家試験すべてで合格水準に達したと報告しました。同じ研究は、日本の医療で避けるべき選択肢、たとえば安楽死を選ぶことがあったとも指摘しています。
出典
一次資料Large Language Models Encode Clinical Knowledge — Singhal et al., arXiv:2212.13138, Dec 26, 2022
最初の公開。MultiMedQA と HealthSearchQA、Flan-PaLM の MedQA 67.6%、Med-PaLM はなお臨床医に劣るという結論
Nature 掲載版の全文。科学的コンセンサスとの一致(Med-PaLM 92.6%・臨床医92.9%)、有害になりうる回答(5.9%・5.7%)、140問を1人ずつが評価、限界の節
Med-PaLM 2。Med-PaLM が初めて合格点を越えた(67.2%)という記述、MedQA 最大86.5%、1066問の比較で9軸中8軸で医師の回答より好まれた
Med-PaLM 2 の査読版。実際の質問による試験で専門医が一般医の回答より65%の割合で Med-PaLM 2 を好んだが、全体では専門医の回答が好まれた
一次資料Med-PaLM — Google Research
合格ライン(60%超)を初めて越えた AI システムという Google の位置づけ、2023年3月の The Check Up での Med-PaLM 2 発表、MedLM、Med-PaLM M
GPT-4 が6年分の日本の医師国家試験に合格、安楽死など避けるべき選択肢を選ぶことがある、日本語ではトークン数が増えて費用が高くなる
最終更新: