T1#market
Google が TPU を公表 ── 機械学習のための自社製チップ
メタデータ
- 日付
- 年代
- 2010s
- Tier
- T1
- 参照年表
- AIの歴史 · 半導体・ハードウェアの歴史
- 出典数
- 09
- 関連項目
- 05
- Tags
- #market
2016年5月18日(水曜日)、開発者会議 Google I/O の基調講演で、CEO の Sundar Pichai が、それまで伏せられていた自社製チップの存在を明かした。機械学習のために Google が自ら設計した Tensor Processing Unit(TPU) である。PCWorld によれば、Pichai は TPU が市販のどの GPU や FPGA よりもワットあたり1桁高い性能を出すと述べ、2か月前に李世乭(イ・セドル)を破った AlphaGo もこのチップで動いていたと語った。
発表とはいえ、新製品のお披露目ではなかった。同じ日に公開された Google のブログは、TPU を1年以上前からデータセンターで動かしていると書いている。翌2017年の論文は、配備は2015年からだったとしている。外部の誰も知らないまま、検索や地図のサービスの裏で、すでに働いていたチップの公表だった。
TPU という用語の定義と後の世代の概要は用語集の TPUに、GPU・NPU・ASIC との違いはAI 半導体の項にある。ここでは、Google がなぜ自前のチップを作り、それが外部に開かれるまでを追う。
公表の中身
Google Fellow の Norm Jouppi が書いたブログは、要点を短くまとめている。
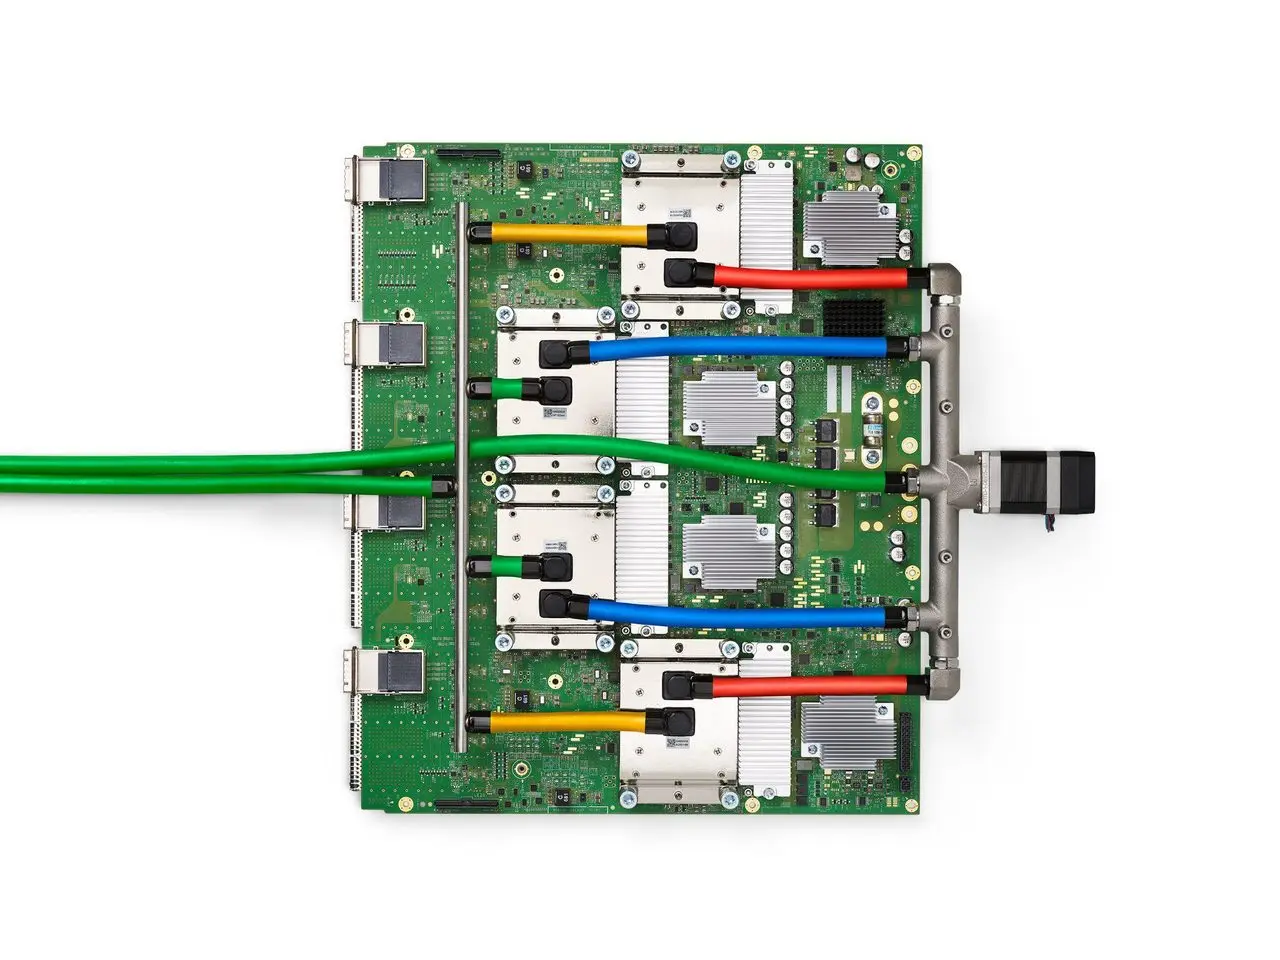
- TPU は機械学習のために作った特注の ASIC で、Google の機械学習フレームワーク TensorFlow に合わせてある
- 計算の精度を下げても構わない用途に絞ったので、1回の演算に要するトランジスタが少なくて済み、そのぶん多くの演算を詰め込める
- TPU を載せた基板は、データセンターのラックのハードディスク用スロットに収まる
- 最初のシリコンが届いてから22日で、実際のアプリケーションを本番の速度で動かした
- 検索結果の関連性を高める RankBrain や、ストリートビューにすでに使われている
ブログは性能について、ワットあたりの性能が1桁高く、これは技術を約7年、ムーアの法則でいえば3世代先に進めたのにほぼ等しいと主張した。ただしこの時点では、何と比べてどう測ったのかは示されていない。会場にいたアナリストの Patrick Moorhead は PCWorld に、TPU は学習ではなく、学習済みのモデルを動かす側を担うものだという見方を示している。PCWorld はまた、2000年代初めに SGI が同じ名前の製品を出していたが、Google によれば関係はないと書いている。
なぜ自前のチップだったのか
理由は、1年後の2017年5月に Google が公開した詳しい解説で語られた。Google は早くも2006年にニューラルネットワーク向けの ASIC を検討していたが、状況が切迫したのは2013年だった。ニューラルネットワークの計算需要が急速に伸び、このままでは運用するデータセンターの数を2倍にしなければならないかもしれないと気づいたのである。
通常、ASIC の開発には数年かかる。TPU は設計・検証・製造からデータセンターへの配備までを15か月で終えた。急いで既存のサーバーに載せるため、プロセッサは外付けのアクセラレータカードにまとめ、SATA のハードディスク用スロットに差し込めるようにした。ホストとは PCIe Gen3 x16 で結ばれる。
2017年の論文が明かした数字
2017年4月、Jouppi ら75人の著者が、第1世代 TPU の論文を公開した。6月の計算機アーキテクチャの国際会議 ISCA で発表されたもので、それまでブログの主張にとどまっていた中身が数字で示された。
| 項目 | 第1世代 TPU(2017年の論文と解説による) |
|---|---|
| 役割 | ニューラルネットワークの推論のみ |
| 配備 | 2015年からデータセンターで稼働 |
| 製造プロセス・動作周波数・消費電力 | 28nm、700MHz、動作時40W |
| 行列演算ユニット | 8ビットの積和演算器 65,536個 |
| ピーク性能 | 92 TOPS |
| チップ上のメモリ | ソフトウェアで管理する28MiB |
| 比較相手 | 同じデータセンターの Intel Haswell CPU と NVIDIA K80 GPU |
| 平均の速さ | GPU・CPU の約15〜30倍 |
| ワットあたり性能 | 約30〜80倍 |
測定に使ったのは、Google のデータセンターでのニューラルネットワーク推論の需要の95%を占める、実際のサービスのモデルだった。論文はまた、CPU や GPU が平均の処理量を上げるために備えるキャッシュやアウトオブオーダー実行などの仕組みを持たず、実行が決定的であることが、99パーセンタイルの応答時間を守る用途に合っていると論じている。ここに示された倍率は、同じ時期に同じデータセンターに入っていた機器どうしを比べたもので、比較の相手が変われば倍率も変わる。
学習へ、そして外部へ
第1世代は推論しかできなかった。学習は従来どおり GPU や CPU が受け持っていた。これを変えたのが、2017年5月の Google I/O で発表された第2世代である。
Google によれば、新しい TPU は1基で最大180テラフロップスの浮動小数点性能を持ち、学習と推論の両方をこなす。専用の高速ネットワークで64基をつないだ「TPU ポッド」は最大11.5ペタフロップスに達し、32個の市販の高性能 GPU で丸1日かかっていた翻訳モデルの学習が、ポッドの8分の1を使って午後のうちに終わったという。
2018年2月12日には Cloud TPU のベータ提供が始まり、外部の開発者が Google Cloud で TPU を借りられるようになった。4つの ASIC を載せた1枚の基板が最大180テラフロップスと64GB の広帯域メモリを持ち、料金は1台1時間あたり6.50ドル。Google は、Cloud TPU 1台で ResNet-50 を ImageNet で所定の精度まで1日足らず、200ドルを大きく下回る費用で学習できると説明した。自社のサービスのために作ったチップが、クラウドの商品になったのである。
| 時期 | 出来事 |
|---|---|
| 2006年 | Google がニューラルネットワーク向け ASIC を検討(同社の説明) |
| 2013年 | 計算需要の急増で開発が急務に |
| 2015年 | 第1世代 TPU がデータセンターで稼働 |
| 2016年3月 | AlphaGo が李世乭と対局。TPU を使用 |
| 2016年5月18日 | Google I/O で TPU を公表 |
| 2017年4月 | 第1世代の論文を公開(6月に ISCA で発表) |
| 2017年5月 | 学習にも対応した第2世代と TPU ポッドを発表 |
| 2018年2月12日 | Cloud TPU のベータ提供開始 |
| 2025年4月 | 第7世代 Ironwood を発表 |
| 2025年10月23日 | Anthropic が最大100万個の TPU を使う計画を公表 |
10年後の TPU
公表から9年後の2025年4月、Google は Google Cloud Next 25 で第7世代の Ironwood を発表し、推論のために設計した初めての TPU だと位置づけた。最大9,216個の液冷チップを1つのポッドにつなぎ、その構成で42.5エクサフロップスに達するという。チップ1個あたりの広帯域メモリは192GB で、電力効率は2018年の最初の Cloud TPU の30倍近いと Google は主張している。いずれも Google 自身の公称値である。
同じ年の10月23日には、Anthropic が最大100万個の TPU を含む Google Cloud の利用拡大を発表した。同社によれば規模は数百億ドルにのぼり、2026年には1ギガワットを大きく超える計算能力が稼働する見込みとされた。社内のデータセンターの増設を避けるために作られたチップは、ほかの AI 企業が計算資源を確保する手段の一つになっていた。
何が変わったか
TPU の公表は、AI の計算を担う道具が GPU だけではないことを、最大級のクラウド事業者が実物で示した出来事だった。汎用の GPU と CUDA のソフトウェア基盤で学習を回すやり方が広がるなかで(CUDA の公開を参照)、Google は自社の用途に合わせて回路を絞る道を選び、その中身を論文で公開した。低い精度の行列演算に専用の回路を割くという方向は、2010年代後半からは GPU の側でも採られるようになった(4ビットの演算形式を加えた NVIDIA Blackwell の発表を参照)。
関連: 半導体・ハードウェアの年表。
よくある質問
- Google の TPU はいつ発表されたのですか。
- 2016年5月18日の Google I/O の基調講演で、CEO の Sundar Pichai が公表しました。ただし Google の説明では、その時点で TPU はすでに1年以上データセンターで使われており、2017年の論文は2015年から配備されていたと書いています。
- 最初の TPU は GPU と何が違ったのですか。
- 第1世代はニューラルネットワークの推論だけを受け持つ ASIC で、8ビットの積和演算器65,536個を並べた行列演算ユニットを中心にしていました。2017年の論文で Google は、同じデータセンターの Intel Haswell CPU と NVIDIA K80 GPU に比べて平均で15〜30倍速く、ワットあたりの性能は30〜80倍高いと報告しています。
- TPU は Google の外でも使えるのですか。
- 使えます。2018年2月12日に Cloud TPU のベータ提供が始まり、Google Cloud で時間単位で借りられるようになりました。当時の料金は Cloud TPU 1台1時間あたり6.50ドルでした。
出典
I/O での Pichai の発言、AlphaGo、SGI の同名製品とは無関係、Patrick Moorhead の見方
一次資料An in-depth look at Google's first Tensor Processing Unit (TPU) — Google Cloud Blog, May 12, 2017
2006年の検討、2013年の危機感、15か月での配備、28nm・700MHz・40W、ハードディスクのスロットに収まるカード
最終更新: