T1#labor
AlphaGo が李世乭に勝利
メタデータ
- 日付
- 年代
- 2010s
- Tier
- T1
- 参照年表
- IT全史 ── 計算機が世界を編み変える · AIの歴史
- 出典数
- 08
- 関連項目
- 05
- Tags
- #labor
2016年3月10日、 第2局。 AlphaGo が37手目を盤の右辺に打つと、 解説席のプロ棋士たちはこの手をどう扱えばよいか分からなかった。 会場にいた WIRED の記者によれば、 一人は「とても奇妙な手だ」と言い、 もう一人は「ミスだと思った」と言った。 李世乭(イ・セドル)は対局室を出て、 応手を決めるまでに15分近くをかけた。
この5番勝負はふつうスコアで要約される。 だが、 より多くを教えてくれるのは2つの手 ── 機械の一手と人間の一手 ── の周辺で起きたこと、 そして機械を作った側がそれをどう説明したかである。
ソウルの前に ── AlphaGo と樊麾
AlphaGo の最初の公式な戦績は、 誰も生中継で見ていない対局から来た。 2015年10月、 欧州チャンピオンに3度輝いた樊麾(ファン・フイ)と非公開で対局し、 5戦全勝した。 DeepMind はこのシステムを記述した論文を2015年11月11日に Nature へ投稿し、 2016年1月27日にオンライン掲載された。 題は「Mastering the game of Go with deep neural networks and tree search」、 著者は David Silver と Aja Huang を筆頭に Demis Hassabis を含む20名である。
要旨には、 その後のすべてを方向づける2つの主張がある。 他の囲碁プログラムに対する勝率は99.8%。 そして樊麾戦の結果は、 計算機プログラムが19路盤の囲碁でプロ棋士を破った最初の例であり、 「少なくとも10年先と考えられていた」到達点だ、 と。 樊麾はプロだったが、 李世乭は世界最強クラスの棋士である。 3月の対局は、 論文の結果が囲碁の頂点で通用するかどうかの試験だった。
AlphaGo はどうやって手を選んだのか
Nature 論文は3つの部品を記述している。
- 方策ネットワーク: 有望な手を提案する。 まず人間の熟練者の手を予測するよう教師あり学習で訓練し、 次にプログラム同士の自己対局による強化学習で改良した
- 価値ネットワーク: 局面を見てどちらが勝っているかを見積もる。 これによって、 すべての変化を終局まで打ち切らずに済む
- モンテカルロ木探索: AlphaGo 以前の最強の囲碁プログラムを支えていた探索法。 これを2つのネットワークで導く
論文によれば、 先読みをまったくしないネットワーク単体でも、 探索型の最強プログラムと同じ水準で打てた。 プロを破ったのはその組み合わせである。 ここが20年前のチェスにおける IBM の Deep Blue との決定的な違いで、 Deep Blue の評価関数は大半が人手で書かれ調整されていたのに対し、 AlphaGo の局面判断は学習で得られたものだった。
AlphaGo 対 李世乭 ── 5局の記録
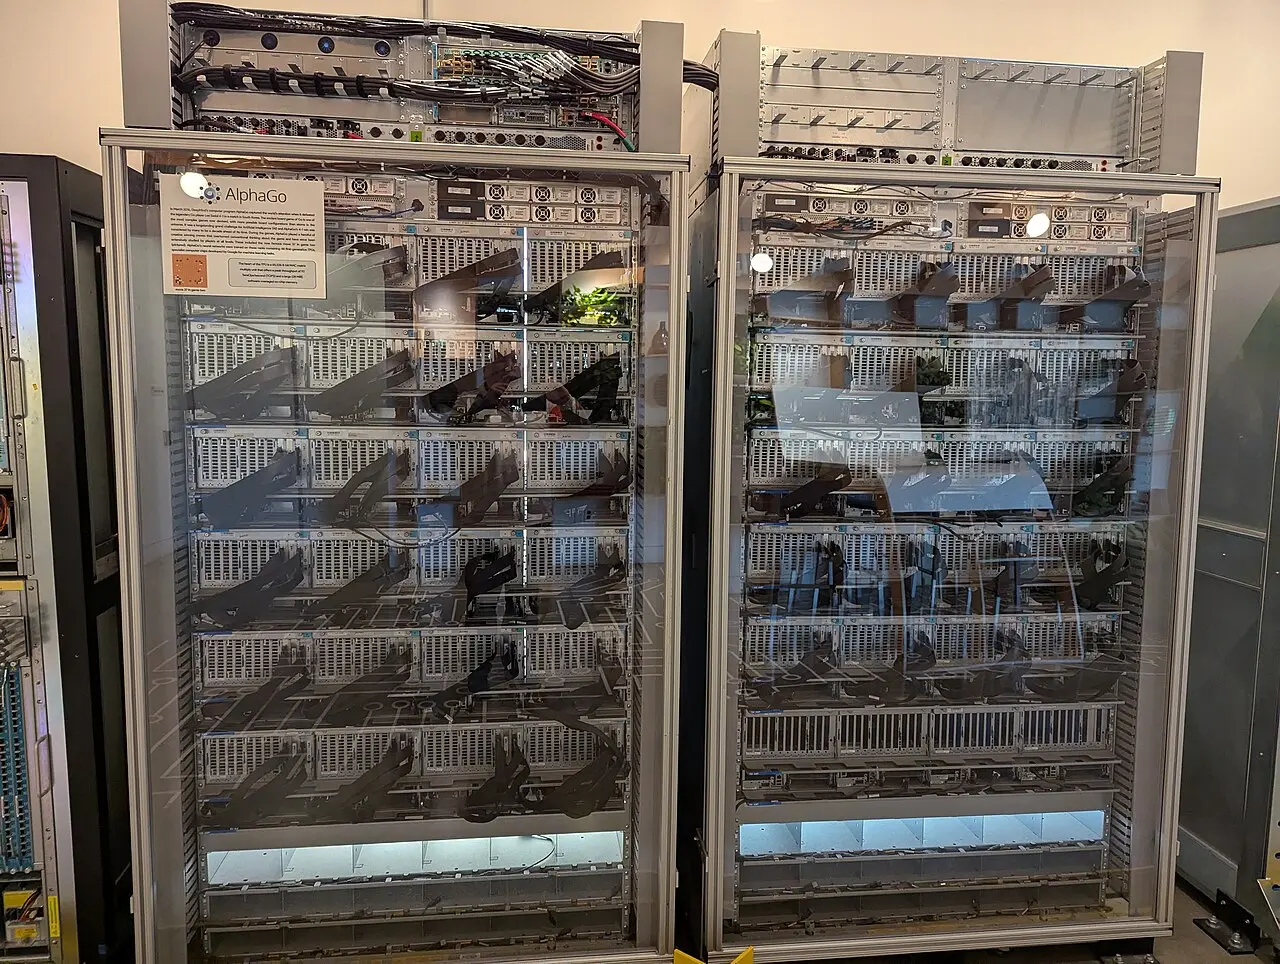
対局はソウルのフォーシーズンズ・ホテルで、 中国ルール・コミ7目半で行われた。 持ち時間は各2時間と、 60秒の秒読み3回。 李の向かいには Aja Huang が座り、 AlphaGo の石を盤に置いた。 分散版のプログラムは CPU 1,920個と GPU 280個で動いていた。
| 局 | 日付 | 勝者 | 手数 |
|---|---|---|---|
| 第1局 | 3月9日 | AlphaGo(白) | 186 |
| 第2局 | 3月10日 | AlphaGo(黒) | 211 |
| 第3局 | 3月12日 | AlphaGo(白) | 176 |
| 第4局 | 3月13日 | 李世乭(白) | 180 |
| 第5局 | 3月15日 | AlphaGo(白) | 280 |
第3局を終えた時点で AlphaGo の勝ち越しは決まっていたが、 残りの2局も打たれた。 第5局を The Korea Times は最後まで競り合いだったと伝えている。 280手で李が投了した。
37手目と78手目
第2局の37手目が注目されたのは、 それが効いたからだけではない。 プロジェクトを率いた David Silver によれば、 AlphaGo は人間がこの手を打つ確率を自ら1万分の1と計算しており、 そのうえで自分の探索と評価がこの手を選んだので打った。 肩ツキという見慣れた種類の手を、 見慣れない場所に打った一手で、 局面は AlphaGo に傾いた。 その時点で5か月にわたって AlphaGo と対局を重ねていた樊麾は、 WIRED の記者に「美しい」と繰り返したという。
第4局はその鏡像になった。 0勝3敗の李は30分ほど考えてから、 盤の中央に割り込む78手目を打った。 AlphaGo は自分がまだ優勢だと見積もったまま次の手で悪手を返し、 87手目のあたりで自らの勝率の見積もりが急落すると、 弱い手を続けて投了に至った。 棋士たちはこの手を「God's Touch(神の一手)」と呼び ── DeepMind も同じ名で呼んでいる ── 中国のプロ棋士・古力も「神の一手」と評した。 対局後に Hassabis が説明したところでは、 AlphaGo はこの手に備えていなかった。 人間がこの手を打つ確率を1万分の1と見積もっていたからだという。 同じ確率が、 今度は逆向きに働いた。
賞金・段位・視聴者
賞金は100万ドルで、 AlphaGo が勝ったため DeepMind は UNICEF や囲碁団体などに寄付した。 韓国棋院は AlphaGo に名誉九段を贈った。 DeepMind はこれを、 計算機の囲碁プレイヤーが受けた最初の、 最高位の認定だと説明している。 DeepMind 自身の発表では、 世界で2億人以上が対局を見た。
対局のあと
DeepMind は李と打った版で止まらなかった。 2017年10月、 Nature は「Mastering the game of Go without human knowledge」を掲載し、 AlphaGo Zero を発表した。 人間の棋譜も、 ルール以外の囲碁の知識も使わず、 自己対局だけで学んだプログラムである。 要旨によれば、 王者を破った既発表の AlphaGo に100対0で勝った。 2016年には不可欠に見えた教師あり学習の段階は、 実は要らなかったことになる。
李世乭にとって、 この対局はその後の棋士人生の枠組みになった。 2019年11月、 李はプロ棋士を引退し、 聯合ニュースに対して理由は AI の台頭だと語った。 自分が一番になったとしても、 勝てない存在がいる、 という趣旨である。
囲碁の後の研究所の歩み ── タンパク質の構造予測からノーベル賞まで ── は DeepMind と Hassabis のページで扱っており、 ここでは繰り返さない。 この対局が AI の長い歴史のどこにあるかは AI の年表 を参照。 深層学習を復活させた 2012年の ImageNet と、 翌年の Transformer 論文 の間に位置している。
よくある質問
- AlphaGo と李世乭の対局はいつ行われ、どちらが勝ったのか
- 2016年3月9日から15日にかけてソウルで5番勝負が行われ、AlphaGo が4勝1敗で勝ちました。李世乭が勝ったのは3月13日の第4局だけです。
- 第2局の37手目はなぜ有名なのか
- AlphaGo 自身が「人間が打つ確率は1万分の1」と見積もった肩ツキで、解説者が当初は悪手と疑うほど異例の手だったからです。この手は第2局の勝利につながりました。第4局では李世乭が、AlphaGo の見積もりでは同じく1万分の1の78手目を返し、こちらは「神の一手」と呼ばれました。
- AlphaGo はどうやって強くなったのか
- 2016年の Nature 論文によれば、人間の熟練者の棋譜で教師あり学習した「方策ネットワーク」と、自己対局の強化学習で鍛えたネットワーク、局面を評価する「価値ネットワーク」を、モンテカルロ木探索と組み合わせています。人間の棋譜を一切使わない後継の AlphaGo Zero は2017年に発表されました。
出典
一次資料Silver, D. et al. (2017). Mastering the game of Go without human knowledge. Nature 550, 354–359
AlphaGo Zero が李世乭に勝った版の AlphaGo に100対0で勝ったという報告
二次資料Metz, C. In Two Moves, AlphaGo and Lee Sedol Redefined the Future — WIRED, 16 March 2016
37手目・78手目がいずれも AlphaGo の見積もりで1万分の1だったこと(David Silver、Demis Hassabis の説明)、78手目が中央の割り込みだったこと
最終更新: