T1#research
Transformer 論文「Attention Is All You Need」
メタデータ
- 日付
- 年代
- 2010s
- Tier
- T1
- 参照年表
- AIの歴史
- 出典数
- 07
- 関連項目
- 04
- Tags
- #research
「Attention Is All You Need」の最初の脚注は、 8人の著者が並ぶ論文としては珍しい書き方をしている。 冒頭は "Equal contribution. Listing order is random."(全員が同等に貢献、 掲載順は無作為)。 そのあとに分担が続く。 RNN を Self-Attention で置き換える案を出して検証を始めたのは Jakob Uszkoreit。 最初の Transformer モデルを設計・実装したのは Ashish Vaswani と Illia Polosukhin。 scaled dot-product attention、 multi-head attention、 パラメータを持たない位置表現を提案したのは Noam Shazeer。 Niki Parmar は無数の派生モデルを設計・調整・評価し、 Llion Jones は初期のコードベースと推論の効率化・可視化を担い、 Łukasz Kaiser と Aidan Gomez は旧コードを置き換えるライブラリ tensor2tensor を作った。
構造の説明より先にこの脚注を読む価値がある。 Transformer がひとりの発明者ではなく集団の仕事として語られる理由が、 ここに書いてあるからだ。 筆頭に来た名前は、 くじの結果にすぎない。
Transformer 論文が解こうとした問題
2017年の時点で、 ニューラル機械翻訳の主流は再帰型ネットワーク(RNN、 LSTM、 GRU)で組んだエンコーダ・デコーダだった。 論文の序論はその限界を正面から書く。 再帰型モデルは各位置の隠れ状態を直前の位置の隠れ状態から計算するので、 その「本質的に逐次的な性質」が1つの訓練例の中での並列化を妨げ、 系列が長くなるほど問題になる、 と。
Attention そのものは新しくなかった。 Dzmitry Bahdanau、 Kyunghyun Cho、 Yoshua Bengio は2014年9月に初版が出た論文で、 再帰型の翻訳器に「ソフトな位置合わせ」の仕組みを加え、 原文全体を1本の固定長ベクトルに押し込む代わりに、 デコーダが原文のどこでも振り返れるようにしていた。 ただし2017年の論文が指摘するとおり、 そうした Attention は「ごく一部の例外を除いて」再帰型ネットワークと組み合わせて使われていた。 逐次処理のボトルネックには畳み込みで挑む研究もあり、 論文は Extended Neural GPU、 ByteNet、 ConvS2S の名を挙げている。
Transformer の提案は、 その中で最も急進的な選択だった。 Attention は残し、 再帰も畳み込みも捨てる。
Transformer の構造
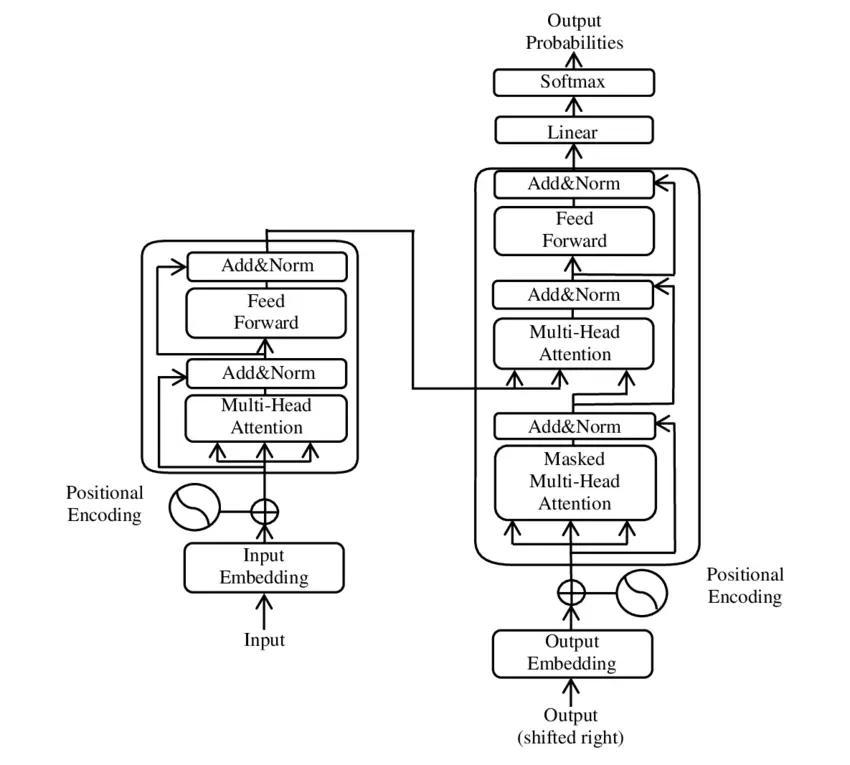
論文のモデルは、 翻訳システムがすでに持っていたエンコーダ・デコーダの形をそのまま保っている。 変わったのは、 その中身である。
- Self-Attention: 文中のすべての位置が、 他のすべての位置の重み付き和を計算する。 重みはある位置の「クエリ」と各位置の「キー」の内積から求め、 キーの次元の平方根で割る。 これが scaled dot-product attention の名の由来である
- Multi-Head Attention: Attention を1回計算する代わりに、 base モデルでは小さく射影した8系統を並列に走らせて結合する。 ヘッドごとに別の関係を追えるようになる
- 位置エンコーディング: 再帰が無いので、 モデルは語順を知らない。 論文は周波数の異なる正弦波・余弦波を入力の埋め込みに足した。 学習で位置埋め込みを得る方式も試し、 結果は「ほぼ同一」だったと報告している
- 積み重ね: base モデルはエンコーダ・デコーダそれぞれ6層、 モデル幅512、 パラメータ数は約6500万。 big モデルは約2億1300万
Transformer 論文が報告した数字
主張は翻訳の品質と、 学習のコストの2点にあった。
| 項目 | 論文の記載 |
|---|---|
| WMT 2014 英→独(big) | BLEU 28.4。 アンサンブルを含む既存最高値を2ポイント超上回る |
| WMT 2014 英→仏(big) | 要旨では BLEU 41.8(12月版の本文の結果節では 41.0) |
| ハードウェア | NVIDIA P100 を8枚積んだマシン1台 |
| base モデルの学習 | 10万ステップ、 約12時間 |
| big モデルの学習 | 30万ステップ、 約3.5日 |
翻訳を含まない英語の構文解析(constituency parsing)にも適用し、 構造が汎用的であることを示そうとしている。 英仏の数値の食い違いは論文自体にあるもので、 このページはどちらかに決めずに両方を載せる。
後に効いてきたのはコストの行だった。 著者らは、 Transformer は8枚の P100 で「わずか12時間」学習させるだけで翻訳品質の新しい最高水準に届きうる、 と書いた。 文全体にわたって並列化できる学習は、 ハードウェアを足せば足すほど速くなる学習でもある。 BLEU の数字以上に、 この性質が後続の研究に使われることになる。
誰が、 どこで書いたのか
研究は Google で行われた。 各著者には "Work performed while at Google Brain" か "Work performed while at Google Research" のどちらかの脚注が付く。 ただし名前の下に印刷された所属はもう少し入り組んでいて、 Aidan N. Gomez はトロント大学、 Illia Polosukhin は Google ではなく個人のメールアドレスで載っている。
arXiv 上の履歴も1つの日付では済まない。 第1版の投稿が2017年6月12日、 同じ月のうちに3回改訂され、 第5版が12月6日。 論文は米カリフォルニア州ロングビーチで開かれた第31回 Neural Information Processing Systems(NIPS 2017)で発表された。 2023年7月と8月にもさらに2つの版が追加されている。
Transformer の上に建ったもの
論文の結論は、 適用範囲について控えめだった。 テキスト以外の入出力 ── 画像・音声・動画 ── に Transformer を広げ、 大きな入出力を効率よく扱える局所的な Attention を調べる、 というのが今後の計画として書かれている。
先に起きたのは言語の側の変化だった。 OpenAI の Alec Radford、 Karthik Narasimhan、 Tim Salimans、 Ilya Sutskever による論文「Improving Language Understanding by Generative Pre-Training」 ── いま GPT と呼ばれるモデル ── は、 モデル構造に Transformer を使うと明記している。 採用したのはデコーダだけの12層版で、 ラベルの無いテキストで事前学習してから個別のタスクに微調整する。 Google の BERT は2018年10月11日に初版が出て、 名前そのものに構造を入れた ── Bidirectional Encoder Representations from Transformers。 GPT はデコーダ、 BERT はエンコーダと、 元のモデルの反対側をそれぞれ取り出し、 両者の間で 大規模言語モデル の型が決まっていく。 その先に ChatGPT がある。
被引用の記録もそれを映している。 Nature は2025年、 5つの主要データベースを横断して21世紀に発表された論文の被引用順位を集計した。 トロント大学の報告によれば、 「Attention is all you need」はその7位に入った。
この論文をどう位置づけるか
Transformer は Attention を発明したわけではなく、 単独で大規模言語モデルを生んだわけでもない。 どちらもよく見かける言い方で、 どちらも言い過ぎである。 この論文が示したのはもっと狭く、 そしてもっと使い道のあることだった ── Attention だけで競争力のある系列モデルが組めること、 そしてそのモデルが2017年のハードウェアで、 GPU 8枚・半日という規模で学習できること。 Attention 機構は再帰型の時代から来たものであり、 規模は後から、 並列学習が何を可能にするかに気づいた人々が持ち込んだ。
この前段にあたるニューラルネットワークの復権は 2012年の ImageNet と AlexNet を、 Transformer が70年の AI 史のどこに位置するかは AI の年表 を参照。
よくある質問
- Attention Is All You Need はいつ発表されたのですか。
- arXiv への投稿が2017年6月12日、査読を経ての発表は同年12月の NIPS 2017(米ロングビーチ)です。著者は Ashish Vaswani ら8名で、研究は Google Brain と Google Research で行われました。
- Transformer は何を置き換えたのですか。
- 機械翻訳などで主流だった、RNN や LSTM を使うエンコーダ・デコーダです。RNN は語を順番に処理するため1つの文の中で計算を並列化できませんでしたが、Transformer は Self-Attention で全位置を同時に扱います。論文では8枚の P100 GPU で base モデルを12時間学習させるだけで当時の最高水準に届いたと報告しています。
出典
一次資料Vaswani, A. et al. (2017). Attention Is All You Need. arXiv:1706.03762
投稿履歴(v1 2017年6月12日、v5 12月6日)、著者・所属、BLEU 値、P100 での学習時間、貢献分担の脚注
Transformer 以前、RNN と組み合わせて使われていた Attention の代表例
モデル構造に Transformer(デコーダのみ12層)を採用したと明記
Nature の集計(5つのデータベース)で7位、という記述
最終更新: