T1#research#open-source#ethics
word2vec ── 単語を意味の近さで並べたベクトルに
メタデータ
- 日付
- 年代
- 2010s
- Tier
- T1
- 参照年表
- AIの歴史
- 出典数
- 07
- 関連項目
- 05
- Tags
- #research#open-source#ethics
word2vec は、単語を数百次元の実数ベクトルに変換する手法と、その実装の名前である。出発点は、Google の Tomas Mikolov、Kai Chen、Greg Corrado、Jeffrey Dean の4人が2013年1月16日に arXiv に投稿した論文「Efficient Estimation of Word Representations in Vector Space」で、意味や文法上の働きが近い単語ほど近いベクトルになるよう、大量の文章から速く学習する2つのモデルを示した。同年8月に Google がコードを word2vec の名でオープンソース化し、10月には改良を加えた続編論文が投稿されて NIPS 2013 に採録された。
単語をベクトルで表すこと自体は新しくない。何が新しかったのかは、論文の要旨がはっきり書いている。16億語のデータから、高品質な単語ベクトルを1日足らずで学習できる、というのである。ベクトルそのものの考え方は 埋め込み表現 の項にまとめてあるので、ここでは2013年に何が起き、何が後に残ったかを追う。
2つの浅いモデル ── CBOW と Skip-gram
それまでのニューラル言語モデルは隠れ層を持つ重い構造で、論文によれば、既存の手法で数億語を超えるデータを学習できた例は知られていなかった。Mikolov らは計算の大半を占める非線形の隠れ層を取り除き、2つの単純な構造を提案した。
| モデル | 何を予測するか | 論文での比較(640次元、正答率) |
|---|---|---|
| CBOW(Continuous Bag-of-Words) | 前後の文脈の単語から、真ん中の単語を当てる | 意味的な問題24%、文法的な問題64% |
| Skip-gram | 真ん中の単語から、周囲の単語を当てる | 意味的な問題55%、文法的な問題59% |
| 比較:従来型のニューラル言語モデル(NNLM) | ── | 意味的な問題23%、文法的な問題53% |
数値は同じデータで学習させたときの、論文の表3の値である。文法的な関係では CBOW がやや良く、意味的な関係では Skip-gram が大きく上回った。大規模な実験には Google News のおよそ60億トークンのコーパスを使い、語彙は頻度上位の100万語に絞っている。
「King − Man + Woman」と試験集合
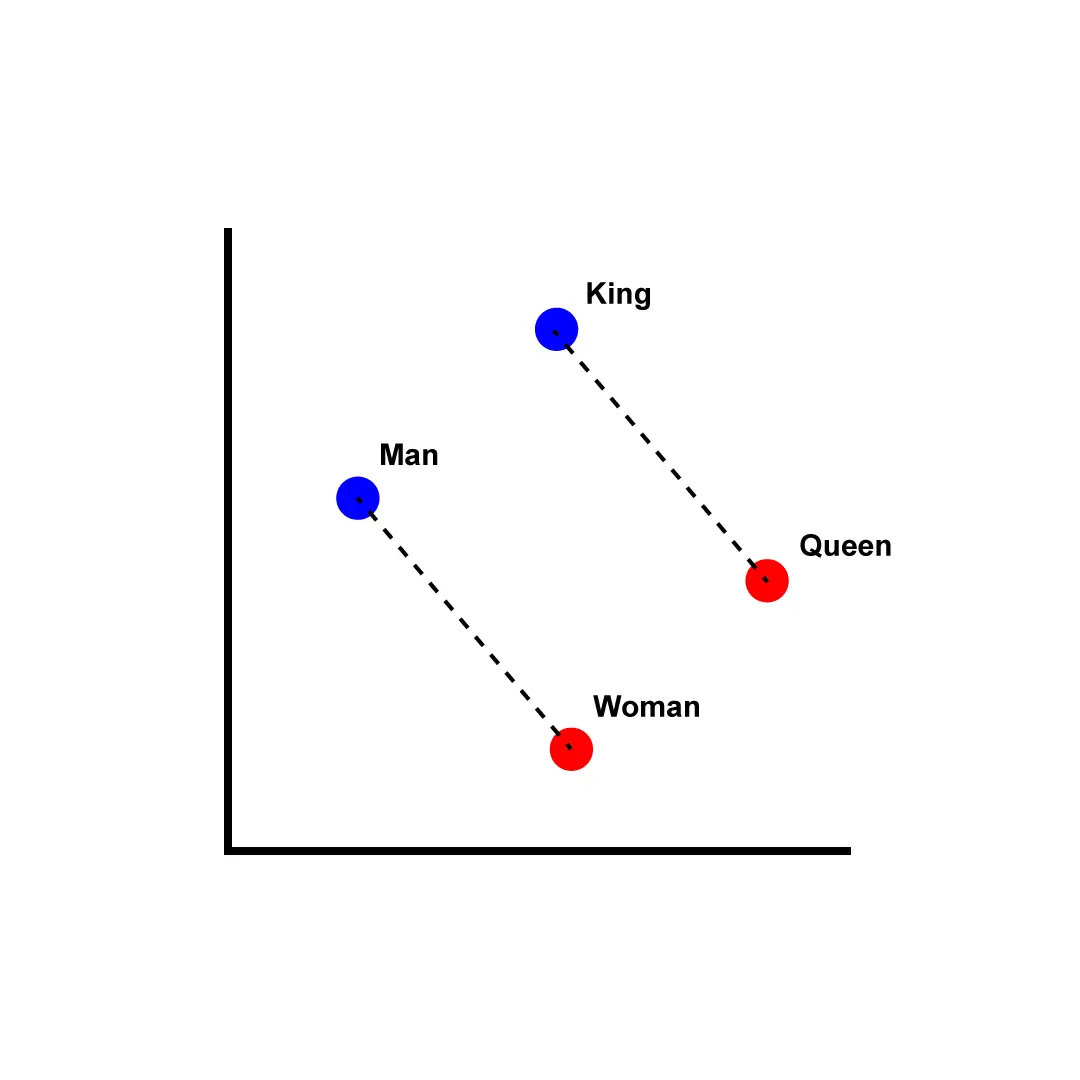
word2vec と聞いて多くの人が思い出すのは、王(King)から男(Man)を引き、女(Woman)を足すと女王(Queen)になるという例だろう。論文はこれを、vector("King") − vector("Man") + vector("Woman") の結果が Queen のベクトルに最も近くなる、と書いている。ただし論文自身はこの例を、Mikolov らの先行研究で示された結果として引用している。
2013年の論文の貢献は、こうした関係を体系的に測る仕組みを作ったことにある。「big に対する biggest と同じ関係で、small に対応する語は何か」といった問いを集め、意味的な問題8,869問と文法的な問題10,675問からなる試験集合を用意した。答えはベクトルの足し引きで求め、コサイン距離で最も近い単語を探す。論文は、十分に学習したベクトルなら「フランスとパリの関係は、ドイツとベルリンの関係と同じ」といった微妙な意味の関係まで答えられると述べている。
公開と続編 ── 2013年8月と10月
論文の改訂版によると、最初の版を書いたあと、チームは CBOW と Skip-gram を計算する1台用のマルチスレッド C++ コードを公開し、1000億語超で学習した140万件超の固有表現のベクトルも出した。Google の Open Source Blog は2013年8月14日、Mikolov、Ilya Sutskever、Quoc Le の連名で word2vec のオープンソース化を告げている。記事は、モデルが人手の教師なしにニュース記事から国と首都の関係を学んだ例を示し、応用先として知識の抽出、機械翻訳、質問応答、対話システムを挙げた。
| 日付 | 出来事 |
|---|---|
| 2013年1月16日 | arXiv に第1版を投稿(CBOW と Skip-gram) |
| 2013年8月14日 | Google が word2vec をオープンソース化と発表 |
| 2013年9月7日 | 第1論文の第3版。公開したコードと固有表現ベクトルに触れる |
| 2013年10月16日 | 続編論文を arXiv に投稿。NIPS 2013 に採録 |
| 2023年12月 | 続編論文が NeurIPS の Test of Time 賞 |
続編の「Distributed Representations of Words and Phrases and their Compositionality」には Ilya Sutskever が加わった。頻出語を間引くサブサンプリングと、計算を軽くするネガティブサンプリングを導入し、1台で1日に1000億語超を学習できるとした。「Air」と「Canada」の意味を足しても航空会社の Air Canada にはならない、という問題も取り上げ、句をまとめて1つのベクトルにする方法を示している。NeurIPS は2023年、この論文に Test of Time 賞を贈り、被引用が4万回を超えると紹介した。
何を変えたか ── 下流の部品として
論文の結びは、高品質な単語ベクトルが将来の自然言語処理の重要な部品になると予想していた。実際、単語を「意味の近さを保ったベクトル」に置き換える発想は、のちの言語モデルの入り口になった。2017年の Transformer も、入力の単語を学習した埋め込みでベクトルに変えてから処理している。一方で続編論文自身が、単語の表現は語順を考慮せず、慣用句をうまく表せないことを限界として挙げていた。文脈全体を読む表現は、BERT などの次の世代に持ち越された。
利用者の側から見ると、変化は目立たない形で広がった。2016年の Bolukbasi らの論文は、単語埋め込みが文書の順位づけ、感情分析、質問の検索といった下流の応用に使われ、ウェブ検索から履歴書の解析まで数百から数千の論文が書かれてきたと述べている。コードとベクトルが公開されたことで、大きな計算資源を持たない研究者や企業も同じ部品を使えた。
偏りの指摘 ── 2016年
便利さの裏側も、ほどなく数字で示された。Boston University と Microsoft Research の Tolga Bolukbasi らは2016年7月の論文で、Google News の記事で学習した埋め込みでさえ性別のステレオタイプを "to a disturbing extent"(憂慮すべき程度に)含むと報告した。題名のとおり、男と計算機プログラマーの関係は、女と主婦(homemaker)の関係に対応してしまう。
著者らは、埋め込みが広く使われるほど偏りが増幅されるおそれがあると論じた。履歴書の解析や検索のような場面では、学習データの偏りが、そのまま誰かの機会に影響しうる。論文は偏りを減らす手法を提案する一方で、反対の立場も紹介している。埋め込みの偏りは社会の偏りを映しているだけで、直すべきは社会の側だという見方と、用途によっては偏った統計がむしろ役に立つという見方である。著者らはそれでも、偏見を増幅する危険を考えれば中立の側に倒すべきだと勧めた。
よくある質問
- word2vec とは何ですか。
- 単語を数百次元の実数ベクトルに変換する手法と、その実装の名前です。意味や文法上の働きが近い単語ほど近いベクトルになるように、大量の文章から学習します。Google の Tomas Mikolov らが2013年に論文で発表し、同年8月にコードを公開しました。
- CBOW と Skip-gram の違いは何ですか。
- CBOW は前後の文脈の単語から真ん中の単語を予測し、Skip-gram は逆に真ん中の単語から周囲の単語を予測します。2013年の論文の比較では、文法的な関係を問う問題では CBOW がやや良く、意味的な関係を問う問題では Skip-gram が大きく上回りました。
- 「King − Man + Woman = Queen」は word2vec の論文が見つけたのですか。
- 厳密には違います。2013年1月の論文は、この例を Mikolov らの先行研究で示された結果として引用しています。word2vec の論文の貢献は、こうした関係を保つベクトルを桁違いに大きなデータで速く学習する方法と、その精度を測る試験集合を示したことです。
- word2vec の埋め込みに偏りはありますか。
- あります。2016年に Boston University と Microsoft Research の研究者が、Google News の記事で学習した埋め込みにも性別のステレオタイプが強く表れることを示し、偏りを減らす手法を提案しました。学習に使った文章の偏りが、そのままベクトルの幾何に写るためです。
出典
CBOW と Skip-gram、16億語を1日足らず、8,869問の意味的質問と10,675問の文法的質問、Google News 約60億トークン・語彙100万語、King − Man + Woman の例は先行研究[20]の引用、C++ コードと1.4百万の固有表現ベクトルの公開
頻出語のサブサンプリングとネガティブサンプリング、Air Canada などの句ベクトル、1台で1日に1000億語超を学習、Madrid − Spain + France が Paris に最も近い
word2vec のオープンソース化、国と首都の関係を人手の教師なしにニュース記事から学んだ例、想定する応用
一次資料Announcing the NeurIPS 2023 Paper Awards — NeurIPS Blog, Dec 11, 2023
Test of Time 賞。被引用4万回超
Google News で学習した埋め込みの性別ステレオタイプ、偏りを減らす手法
最終更新: