T1#research#consumer#labor#japan
Google ニューラル機械翻訳 ── 一夜で変わった英日翻訳
メタデータ
- 日付
- 年代
- 2010s
- Tier
- T1
- 参照年表
- AIの歴史
- 出典数
- 09
- 関連項目
- 06
- Tags
- #research#consumer#labor#japan
GNMT(Google Neural Machine Translation)は、Google が2016年9月27日に発表した、深層学習による機械翻訳システムである。発表と同時に Google 翻訳の中国語から英語への翻訳をすべて GNMT に切り替え、2016年11月15日(日本では16日)には日本語を含む英語との8言語対に広げた。日本語と英語のあいだの翻訳が「急に読める日本語になった」と多くの人が気づいたのは、この11月の切り替えである。
それまでの Google 翻訳は、文を語句に分けてそれぞれ訳し、統計的にもっともらしい組み合わせを選ぶ句ベースの統計翻訳だった。Google の日本語ブログは、Google 翻訳が統計的な機械翻訳の先駆けとして始まったと振り返っている。統計翻訳が生まれた経緯は 統計的機械翻訳 のページにある。GNMT はこれを、文全体を1つの単位として扱うニューラルネットワークに置き換えた。
2016年9月 ── 論文と中国語→英語の切り替え
Google の研究者 Yonghui Wu、Mike Schuster らは2016年9月26日、論文「Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translation」を arXiv に投稿した。著者には工藤拓、賀沢秀人ら日本人の研究者も名を連ねている。翌27日、Quoc V. Le と Mike Schuster が Google の研究ブログで実運用への投入を発表した。
| 要素 | 内容 |
|---|---|
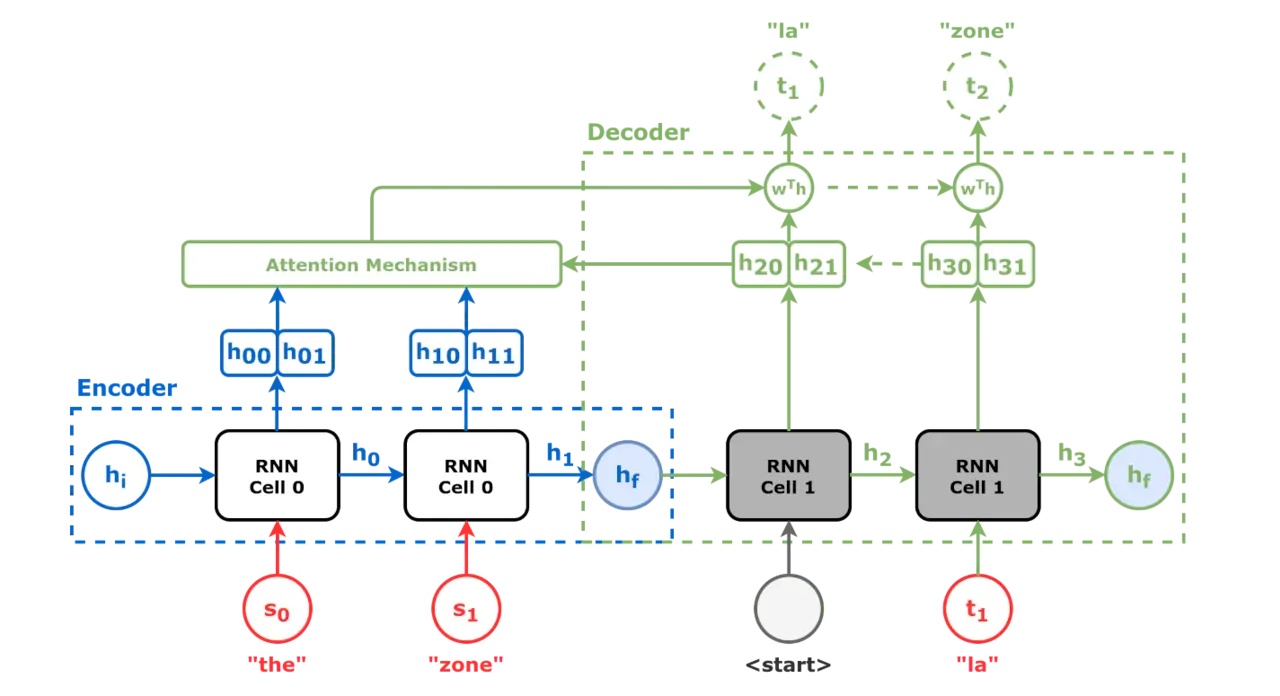
| 構造 | 8層の LSTM のエンコーダと8層のデコーダをアテンションでつなぐ |
| 深くするための工夫 | 層の間に残差接続(ResNet の論文を引用) |
| まれな語の扱い | 単語をワードピースという部品に分ける。もとは Google の音声認識で日本語・韓国語の分割問題を解くために開発された方式 |
| 速度 | 推論に低精度の演算を使い、Google の専用チップ TPU で加速 |
| 評価(Google による) | 人間の評価者による並列比較で、従来の句ベース翻訳より誤りを平均60%削減 |
論文によれば、単純に LSTM を積むと4層まではうまく働くが、6層ではかろうじて、8層を超えるとうまく学習できなかった。残差接続はこの壁を越えるために入れられた。ワードピースは、文字単位の柔軟さと単語単位の効率のあいだを取る方式で、辞書にない語でも部品の組み合わせとして訳せる。
研究ブログによると、9月27日の時点で Google 翻訳のモバイルとウェブの中国語→英語翻訳はすべて GNMT になり、その数は1日約1800万件だった。ブログは、主要な言語対で誤りを55%〜85%以上減らしたとしている。いずれも Google 自身が、Wikipedia やニュースサイトから抜き出した文で行った評価である。
2016年11月 ── 日本語を含む8言語対へ
| 日付 | 出来事 | 対象 |
|---|---|---|
| 2016年9月26日 | 論文を arXiv に投稿 | ── |
| 2016年9月27日 | 研究ブログで発表、実運用を開始 | 中国語→英語 |
| 2016年11月15日(米国) | Google のブログで発表 | 英語と仏・独・西・葡・中・日・韓・トルコ語の8言語対 |
| 2016年11月16日(日本) | Google Japan ブログ「Google 翻訳が進化しました。」 | 同上 |
11月の発表で Google 翻訳の製品責任者 Barak Turovsky は、この8言語対が世界人口の約3分の1の母語にあたり、Google 翻訳のクエリの35%超を占めると書いた。そのうえで、"Google Translate is improving more in a single leap than we've seen in the last ten years combined"(Google 翻訳はこの1回で、過去10年分を合わせたより大きく進歩する)と述べている。これは提供元自身の評価である。同じ日、企業や開発者が API 経由で同じシステムを使えるようにもなった。
日本は最初の拡大の対象に入っていた。ただし日本の利用者の多くは、公式発表より先に変化に気づいていた。
日本で起きたこと
ニューヨーク・タイムズ・マガジンの2016年12月の長編記事によれば、東京大学の暦本純一教授は11月上旬のある金曜の夜、Google 翻訳が急に良くなったという投稿が SNS に流れてくるのに気づいた。暦本氏は自分で試し、ブログに結果を書いた。前半では『グレート・ギャツビー』の野崎孝訳・村上春樹訳と Google の訳を並べ、後半ではヘミングウェイ『キリマンジャロの雪』の冒頭を自分で日本語に訳してから Google で英語に戻し、原文と並べて読者にどちらが機械か当てさせた。同記事は、夜明けまでに Google 翻訳が日本の Twitter のトレンド1位になったと伝えている。
国内の評価も同じ方向を向いていた。ライフハッカー・ジャパンは2016年12月、英語から日本語への翻訳について、主観的に言えば「今まで15点だった翻訳の出来が85点になった」感じだと書いた。アジア太平洋機械翻訳協会(AAMT)会長の中岩浩巳氏は Japio YEAR BOOK 2017 で、それまで日本では人手の辞書と規則によるルールベース翻訳と統計翻訳が主流だったと整理したうえで、2016年11月の導入が日本語に関わる機械翻訳の品質を大幅に改善し、研究者だけでなく社会に大きなインパクトを与えたと評価している。
翻訳の仕事はどう変わったか
ニューラル翻訳が「使える」水準に近づいたことで、問いは「機械翻訳は役に立つか」から「どう使うか」に移った。ライフハッカー・ジャパンの記事は、ビジネスメールの大意をつかむ程度なら新しい Google 翻訳で十分だとする一方、仕事で使うなら原文を読める人のチェックは必須で、意味の通らない訳も少なからず混じると書いた。そのうえで、まず機械に訳させて人が細部を直す、という翻訳者の働き方を提案している。
Google 自身も、機械翻訳は解決済みではないと明言していた。GNMT は単語を落としたり、固有名詞やまれな語を誤訳したり、段落やページの文脈を見ずに文を1つずつ訳したりと、人間の翻訳者ならしない誤りをまだ犯す、と研究ブログは書いている。
機械翻訳への期待と失望には長い歴史がある。1960年代の失望は AI の冬 のページで触れている。GNMT の翌年、Google の研究者たちは再帰を使わずアテンションだけで翻訳する Transformer を発表し、翻訳の主役は再び入れ替わった。AI 全体の流れは AI の年表 に、Google の歩みは Google のページにある。
よくある質問
- GNMT とは何ですか。
- Google が2016年に Google 翻訳へ導入した、ニューラルネットワークによる機械翻訳システムです。文を語句ごとに訳して組み合わせる従来の句ベース統計翻訳と違い、文全体を1つの単位として扱います。8層の LSTM のエンコーダとデコーダをアテンションでつなぎ、単語をワードピースという部品に分けて訳します。
- Google 翻訳の日本語はいつニューラル翻訳になったのですか。
- 2016年11月です。Google は米国時間11月15日、日本では16日付のブログで、日本語を含む英語との8言語対でニューラル機械翻訳の提供を始めたと発表しました。9月27日の最初の導入は中国語から英語への翻訳だけでした。
- 精度はどれくらい上がったのですか。
- Google の論文は、人間の評価者による並列比較で、従来の句ベースの翻訳より誤りを平均60%減らしたとしています。ブログでは主要な言語対で55%〜85%以上の削減としました。いずれも Google 自身の評価です。日本では、ライフハッカー・ジャパンが英日翻訳について主観的には15点が85点になった感じと書きました。
- GNMT で翻訳者は不要になったのですか。
- なっていません。Google 自身が、単語の脱落や固有名詞・まれな語の誤訳、段落の文脈を見ずに文ごとに訳すことなど、人間の翻訳者ならしない誤りが残ると書いていました。日本の評価記事も、仕事に使うなら原文を読める人のチェックが必須だとし、機械で下訳して人が直す働き方を提案しています。
出典
中国語→英語の100%を GNMT に(1日約1800万件)、誤りを55%〜85%以上削減、TensorFlow と TPU、1万超の言語対、残る誤りの種類
8層の LSTM エンコーダ・デコーダ、残差接続、アテンション、ワードピース(もとは音声認識の日本語・韓国語の分割問題のために開発)、TPU での低精度推論、誤りを平均60%削減
英語との8言語対(日本語を含む)、クエリの35%超、103言語、過去10年を合わせたより大きな一歩という表現
一次資料Google 翻訳が進化しました。 — Google 翻訳チーム, Google Japan Blog, 2016年11月16日
日本向けの発表。統計的機械翻訳の先駆けとして始まった経緯、8言語での提供開始
二次資料The Great A.I. Awakening — Gideon Lewis-Kraus, The New York Times Magazine, Dec 14, 2016
東京大学の暦本純一教授が11月上旬の金曜の夜に SNS で変化に気づき、ブログで試したこと、日本の Twitter のトレンド1位
二次資料最近の機械翻訳を取り巻く状況変化とニューラル機械翻訳技術 — 中岩浩巳(アジア太平洋機械翻訳協会 会長), Japio YEAR BOOK 2017
2016年11月の導入が日本語に関わる翻訳品質を大幅に改善し、社会に大きなインパクトを与えたという評価。それまで日本ではルールベースと統計翻訳が主流
最終更新: