T1#research#launch#ethics
DALL·E とは ── 文章から絵を描く AI を OpenAI が示した日
メタデータ
- 日付
- 年代
- 2020s
- Tier
- T1
- 参照年表
- AIの歴史
- 出典数
- 12
- 関連項目
- 05
- Tags
- #research#launch#ethics
DALL·E(ダリ)は、文章から画像を作る OpenAI のモデルである。最初の版は2021年1月5日に研究ブログで発表された。「DALL·E とは何か」に一言で答えるなら、文章で頼めば絵が返ってくるという、のちの画像生成 AI の当たり前を最初に大きく見せたモデルである。ただし最初の DALL·E は誰でも使えるサービスにはならず、利用者が触れられたのは2022年の DALL·E 2 からだった。その公開がゆっくり進むあいだに、2022年夏、Midjourney と Stable Diffusion が誰でも使える形で先に広まった。
名前は、ピクサーのロボット WALL-E と画家サルバドール・ダリを掛け合わせたものだと、英語版 Wikipedia は説明している。
2021年1月5日 ── GPT-3 で画像を描く
OpenAI の発表文によれば、DALL·E は GPT-3 の120億パラメータ版を、文章と画像の組のデータで学習させたものである。仕組みは言語モデルそのものだった。文章と画像を最大1280個のトークンからなる1本の列として受け取り、そのすべてを前から順に予測する。技術的な説明の節では、内訳を文章256トークン・画像1024トークンとし、64層の自己注意層を持つTransformerのデコーダだと書いている。画像を細かい区画の「単語」に直してしまえば、次の単語を当てる仕組みで絵も描ける ── それを大きな規模で確かめた発表だった。
| 項目 | 内容(OpenAI の発表・論文による) |
|---|---|
| 発表 | 2021年1月5日(ブログ) |
| 論文 | "Zero-Shot Text-to-Image Generation"(arXiv、2021年2月24日投稿) |
| 規模 | GPT-3 の120億パラメータ版 |
| 入力 | 文章256+画像1024、最大1280トークンの1本の列 |
| 生成例の選び方 | 1つの文章につき512枚を作り、CLIP で並べ替えた上位32枚 |
| 一般への提供 | なし(DALL·E 2 から段階的に) |
論文の著者は Aditya Ramesh ら8人で、Ilya Sutskever も名を連ねる。論文の要旨は、十分なデータと規模があれば、この単純な方法がその分野向けに作り込まれた従来のモデルと、学習していない課題でも競えると述べている。
アボカドの椅子と、チュチュを着た大根
発表で注目を集めたのは生成例だった。OpenAI は、文章の言い回しを変えながら結果を見られる対話型の図を並べ、DALL·E が何をできて何を苦手とするかを示した。中でも広く引かれたのが、「an armchair in the shape of an avocado」(アボカドの形の肘掛け椅子)という文章に対する一連の椅子である。半分に割ったアボカドの形を背もたれに、種をクッションに見立てたような椅子が並んでいた。「an illustration of a baby daikon radish in a tutu walking a dog」(チュチュを着た大根の赤ちゃんが犬を散歩させている絵)という例もある。
発表文が挙げた能力は、動物や物の擬人化、無関係な概念のもっともらしい組み合わせ、文字の描画、既存の画像の変換だった。弱点も書いている。物の数が増えると、どの物にどの色が付くかの対応を取り違えやすく、成功率が急に下がる。同じ意味の文章に言い換えるだけで結果が崩れることもある。
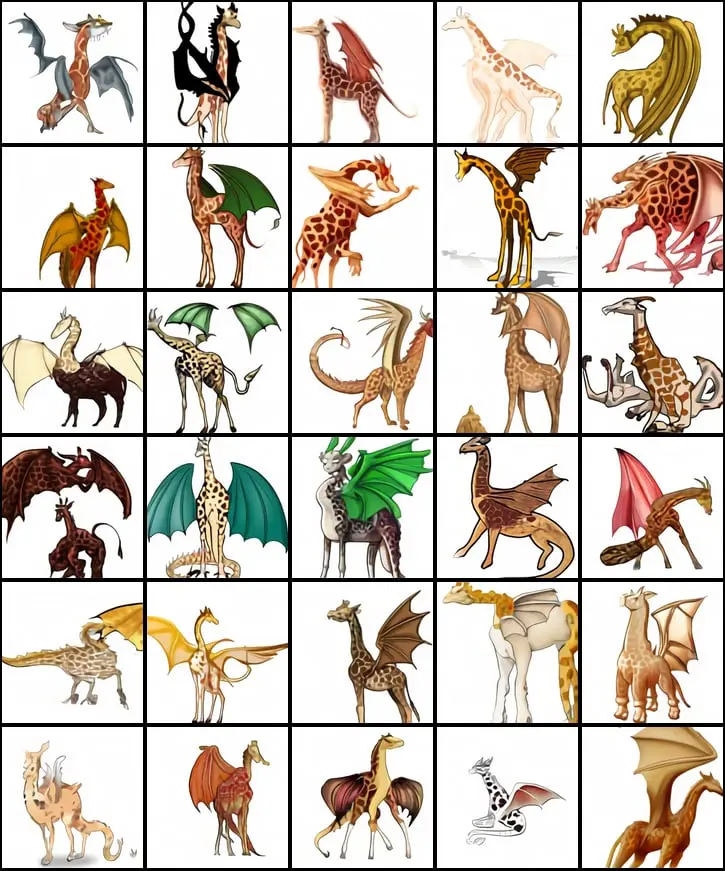
もう一つの注意点は、並んでいたのが「選ばれた」画像だったことである。OpenAI は、各文章について512枚を生成し、CLIP で並べ替えた上位32枚を示したと明記している(サムネイルなど図の外に置いた画像を除き、手作業の選別はしていないとも書く)。CLIP は同じ1月5日に発表された別のモデルで、ネット上の画像とそこに付いた文章を使い、ある画像に本当に付いていた文章を32,768の候補から当てるという課題で学習した。DALL·E が作り、CLIP が選ぶ ── 文章と画像を同じ空間で比べる CLIP は、この後の画像生成の多くの土台になる。
OpenAI は発表文の中で、生成モデルが特定の職業への経済的影響、出力の偏り、長期的な倫理の問題と関わりうることを認め、今後分析すると書いていた。
DALL·E 2 ── 段階的に開かれた扉
後継の DALL·E 2 は2022年4月6日に発表された。OpenAI によれば、最初の DALL·E より写実的で正確な画像を4倍の解像度で生成し、評価者の比較では文章との一致で71.7%、写実性で88.8%が DALL·E 2 を選んだ。中身は別物である。4月13日に投稿された論文は、文章から CLIP の画像表現を作る「事前分布」と、その表現から画像を作る「デコーダ」の2段構えを示し、デコーダには拡散モデルを使った。最初の DALL·E の、トークンを順に予測する方式からの転換だった。
公開は慎重に、段階を踏んで進んだ。OpenAI 自身の記録では、2022年4月に研究プレビューとして限られた利用者に見せ、毎週1,000人ずつ増やした。7月20日にはベータに移り、待機リストから100万人を数週間かけて招待すると発表した。最初の月は50クレジット、以降は毎月15クレジットが無料で、追加は115クレジット15ドル。同じ日から、利用者は生成した画像を転載・販売・商品化する権利を得た。9月28日には待機リストを撤廃し、150万人超の利用者が1日200万枚超の画像を作っていると発表している。11月3日には API の公開ベータが始まった。
安全対策も公開の条件だった。OpenAI は、暴力・ヘイト・成人向けの画像の生成能力を、学習データから露骨な内容を取り除くことで抑え、公人を含む実在の人物の顔を写真のように生成することを防ぐ技術を使ったと説明している。
先に広まった Midjourney と Stable Diffusion
DALL·E 2 の扉がゆっくり開くあいだに、別の道が先に人を集めた。7月に Discord 上でオープンベータに入った Midjourney は、招待なしで誰でも使え、8月にはその作品が コロラド州フェアの美術展で1位 になる。8月22日には Stability AI が Stable Diffusion の重みそのものを公開し、手元の GPU で動かせるようにした。英語版 Wikipedia によれば、OpenAI は最初の3つの DALL·E のいずれについても、コードも重みも公開していない。
DALL·E の名を借りた別物も現れた。最初の DALL·E を参考にした小さなモデル「DALL-E Mini」が2022年に Hugging Face 上で話題になり、OpenAI の求めで6月に Craiyon へ改名している(英語版 Wikipedia による)。
つまり、文章から画像を作るという考えを広く見せたのは DALL·E だったが、それを最初に大勢の手に渡したのは DALL·E ではなかった。閉じたサービスとして段階的に開くか、誰でも使える形で出すか、重みごと配るか ── 2022年の画像生成 AI には、のちに文章の生成 AI でも繰り返される3つの道がそろっていた。
DALL·E 3 と、その後
2023年9月20日、OpenAI は DALL·E 3 を発表した。The Verge によれば、10月に ChatGPT Plus と ChatGPT Enterprise の利用者へ先に提供された。OpenAI は DALL·E 3 を ChatGPT の上に作ったと説明し、ChatGPT が利用者の考えから詳しいプロンプトを自動で書き起こすようにした。存命の画家の画風を求める依頼は断るように設計され、作り手が自分の画像を今後の学習から外すよう申し出る仕組みも用意された。公人を名指しした画像の依頼を断る対策も入っている。
2025年3月25日には、ChatGPT の既定の画像生成が GPT-4o による画像生成に切り替わった。OpenAI はその発表で、DALL·E は専用の GPT から引き続き使えると書いている。ChatGPT の中で画像生成がどう位置づけられてきたかは ChatGPT の記事、画像生成と著作権の争いは AI と著作権の年表 にある。
DALL·E の発表から ChatGPT の公開までは2年足らずである。言語モデルで絵を描けると示した2021年1月の実験は、文章・画像・音声を1つのモデルで扱う流れの早い一歩でもあった。その後の経緯は AI の年表 で辿れる。
よくある質問
- DALL·E はいつ発表されたのですか。
- 最初の DALL·E は2021年1月5日に OpenAI のブログで発表されました。後継の DALL·E 2 は2022年4月6日、DALL·E 3 は2023年9月20日に発表されています。
- 最初の DALL·E は誰でも使えたのですか。
- いいえ。2021年の発表は研究成果の公開で、ブログには生成例が並んでいましたが、一般向けのサービスにはなりませんでした。利用者が触れられるようになったのは DALL·E 2 からで、2022年4月の限定的な研究プレビュー、7月20日のベータ(待機リストから100万人を招待)、9月28日の待機リスト撤廃という順に開かれました。
- DALL·E はどういう仕組みで画像を作るのですか。
- 最初の DALL·E は GPT-3 と同じ Transformer の言語モデルで、文章256トークンと画像1024トークンを1本の列として、前から順に予測しました。生成した候補は同時に発表された CLIP で並べ替えています。DALL·E 2 は方式を変え、文章から CLIP の画像表現を作り、それを拡散モデルで画像に戻す2段構えになりました。
出典
一次資料DALL·E: Creating images from text — OpenAI, January 5, 2021
120億パラメータの GPT-3、1280トークンの列、能力の例(アボカドの肘掛け椅子・大根の絵)、CLIP による並べ替え
解像度4倍、DALL·E 1 との比較評価(71.7%・88.8%)、安全対策、段階的な公開
二次資料OpenAI's new DALL-E 2 system creates realistic images from descriptions — MobileSyrup, April 6, 2022
DALL·E 2 の発表日(OpenAI の2022年4月6日の投稿)と待機リスト
名前の由来、重みとコードが非公開であること、Craiyon(旧 DALL-E Mini)の改名
最終更新: