T1#research#ethics#open-source
GPT-2 の公開見送り ── 段階的公開と AI の公開規範
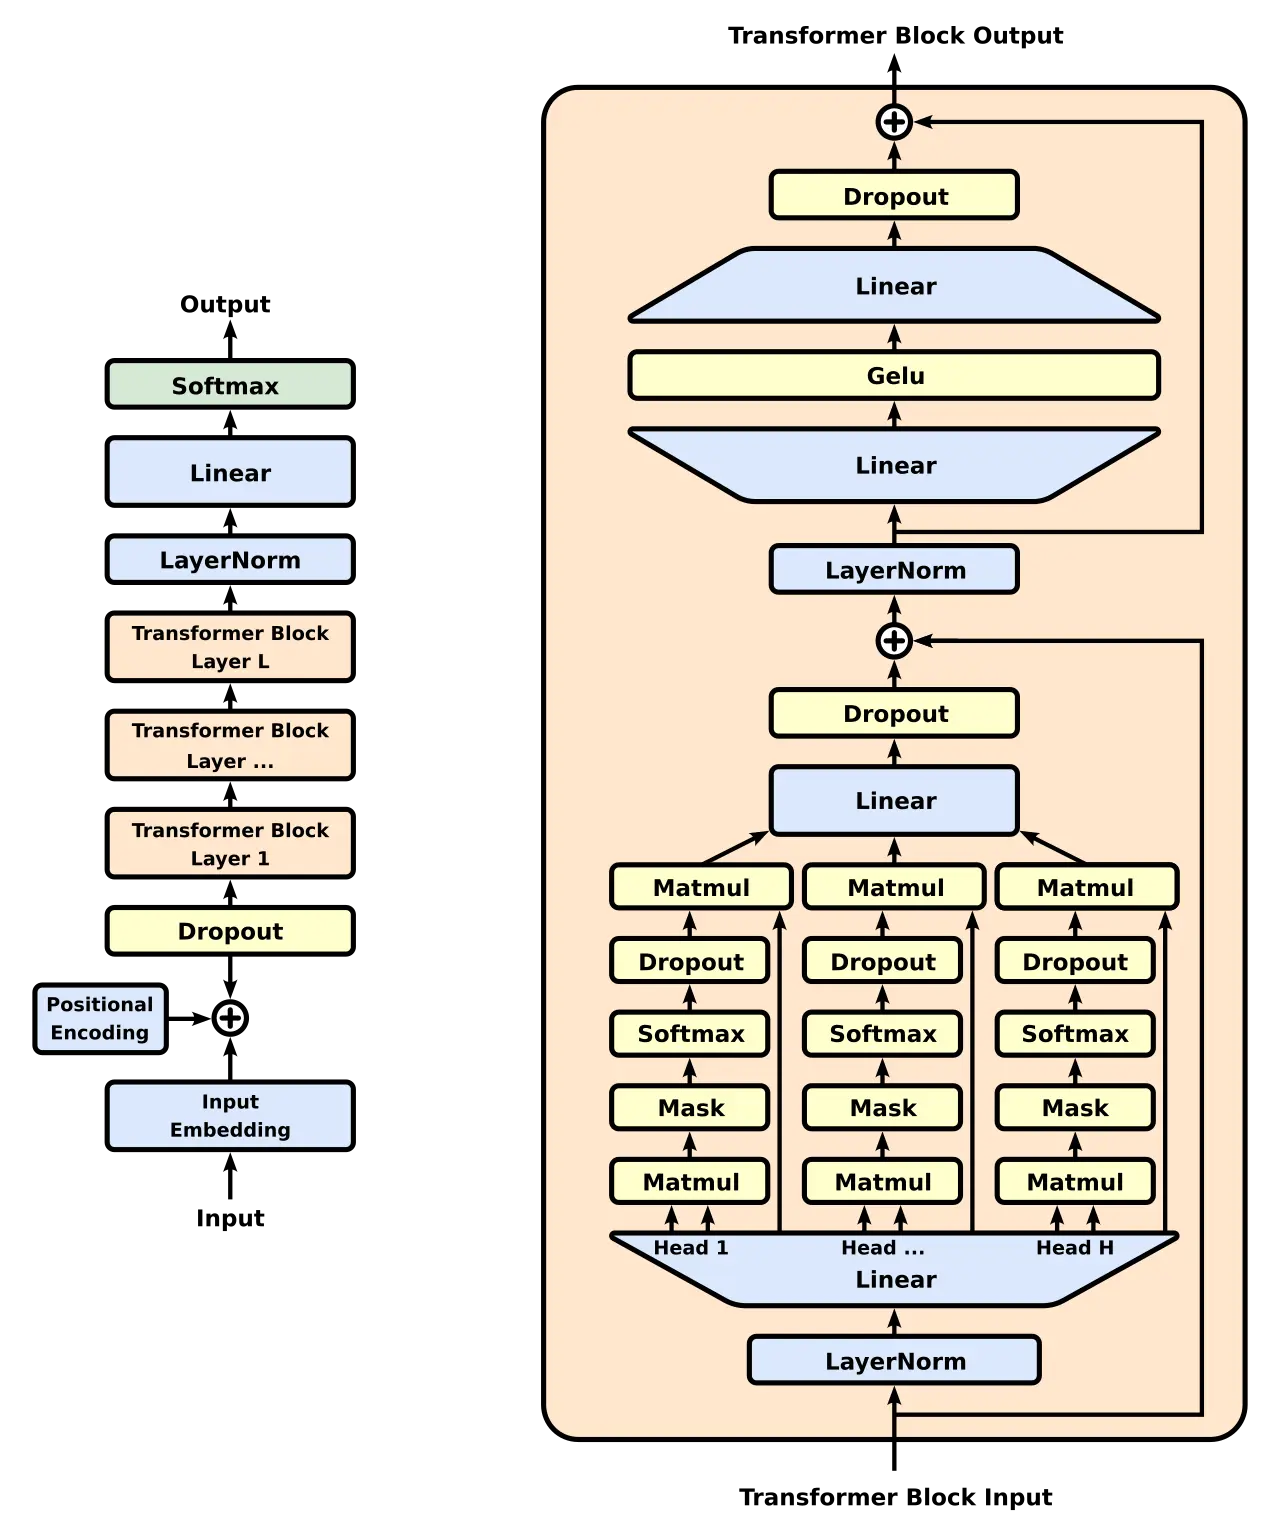
GPT-2 は、OpenAI が2019年2月14日に発表した15億パラメータの言語モデルである。発表と同時に OpenAI は、技術の悪用への懸念を理由に学習済みモデルを公開しないと宣言し、小さな版と論文だけを出した。その後、5月・8月と段階的に大きな版を出し、最大の15億パラメータ版の重みを公開したのは同年11月5日だった。危険すぎて公開できない AI と報じられたこの判断は、研究成果をどこまで、どの順で公開すべきかという公開規範の議論を AI 研究の世界に持ち込んだ。
性能そのものの話は、後継の GPT-3 の記事に譲る。この記事が扱うのは、公開を遅らせるという決定と、それが誰に何をもたらしたかである。
2019年2月14日の発表
OpenAI のブログによると、GPT-2 は前作 GPT をそのまま大きくした Transformer 型のモデルで、ウェブページ800万件・40GB のテキストで「次の単語を予測する」ことだけを学習した。データの集め方には工夫があり、Reddit で3カルマ以上を得た外部リンク先のページだけを使っている。人が「面白い」と判断したページに絞ることで、CommonCrawl のような無差別な収集より質を上げる狙いだった。
ブログの冒頭近くには、こう書かれていた。
Due to our concerns about malicious applications of the technology, we are not releasing the trained model.
(この技術が悪意をもって使われることへの懸念から、学習済みモデルは公開しない)
公開しないものとして挙げられたのは、データセット、学習用コード、そして GPT-2 のモデルの重みである。代わりに、研究者が試せる「ずっと小さな」モデルとサンプリング用のコード、技術論文が出された。OpenAI はこの決定を自ら「実験」と呼び、今日の時点で正しい判断かどうか確信はないとも書いている。生物工学やサイバーセキュリティには悪用の可能性が明らかな研究の公開をめぐる議論の蓄積があり、AI もいずれこの問題に向き合う必要がある、というのが説明だった。
ブログが想定した悪用は4つある。誤解を招くニュース記事の生成、オンラインでの他人へのなりすまし、SNS に投稿する虐待的・偽造コンテンツの自動生成、スパムやフィッシングの文面の自動生成である。一方で、文章作成の補助、より賢い対話エージェント、言語間の翻訳、音声認識の改善といった有益な用途も並べていた。
段階的公開の経過
| 日付 | 公開されたもの | 補足 |
|---|---|---|
| 2019年2月14日 | 小型版(のちの表記で124M)、論文、サンプリング用コード | 15億版・データ・学習コードは非公開 |
| 2019年5月 | 中型版(355M。当時の表記は345M) | 762M・1.5B 版を研究パートナーに限定共有。出力データセットと検出の基準実装も公開 |
| 2019年8月20日 | 大型版(774M)、モデル共有のための法的合意書のひな形 | 公開規範に関する技術報告を公表 |
| 2019年11月5日 | 最大の1.5B 版の重みとコード、出力検出モデル、モデルカード | 段階的公開の最終段 |
8月の報告で OpenAI は、2月以降に GPT-2 を再現した5つを超えるグループと話をしたこと、Hugging Face や Allen Institute for AI とワシントン大学のチームが同様の段階的公開を採ったことを記している。研究パートナーは Cornell 大学(偽情報への人の脆さ)、Middlebury 国際大学院のテロ・過激主義・対テロセンター(CTEC、過激派による悪用)、Oregon 大学(偏りの測定)、Texas 大学 Austin 校(出力の統計的な検出)の4機関だった。
公開の判断に使われた材料
11月5日の最終公開の告知は、判断の根拠を数字で示している。Cornell の調査では、人々が GPT-2 の文章に与えた「信頼性スコア」は10点満点で1.5B 版が6.91、774M 版が6.72、355M 版が6.07だった。OpenAI は、774M 版からの上積みが小さいことを公開に傾いた理由に挙げた。8月の時点では、別の調査で GPT-2 の記事を信頼できると判断した人が72%、本物の New York Times 記事では83%だったとも報告している。
検出については慎重だった。OpenAI が作った検出モデルは1.5B 版の生成文を約95%の割合で見分けたが、単独で使うには精度が足りず、メタデータや人の判断、市民への教育と組み合わせる必要がある、とした。悪用の実態については、これまで強い証拠は見ていないとしつつ、すべての脅威を把握できているわけではないとも書き添えている。CTEC は、白人至上主義やジハード主義など4つの思想で追加学習させれば宣伝文を生成できることを示した。
一連の経緯は、OpenAI の Irene Solaiman ら15人による報告書「Release Strategies and the Social Impacts of Language Models」(2019年8月)にまとめられている。
賛否 ── 「誇大宣伝」か「規範づくりの第一歩」か
反応は二分した。Georgetown 大学 CSET の Helen Toner は、この年でもっとも注目を集めた AI ガバナンスの議論が公開規範であり、その火付け役が GPT-2 だったと振り返っている。Toner の整理では、機械学習の研究者の多くはこれを話題づくりと受け止め、再現や検証を難しくして学術の開放性を損なうと批判した。対照的に、AI 政策・ガバナンスの関係者の反応はおおむね好意的で、今回の研究自体はとくに危険でなくても、悪用されうる研究の公開規範づくりを始めたことを評価した。
Toner はまた、独立研究者の Connor Leahy が GPT-2 を再現し、OpenAI の方針にあえて逆らって公開すると宣言したものの、OpenAI や他の研究者と話した末に非公開へ考えを変えた例を紹介している。ここに、この議論の構図が表れている。重みを止めても、計算資源と技術があれば他者が同じものを作れる。止めることの効果は、時間を稼ぐことに限られる。OpenAI 自身も2月の時点で、自分たちの戦略は最初に再現・公開しうる組織の数を絞り、議論の時間を稼ぐものだと説明していた。
その後に残したもの
得をした人と失った人で整理すると、短期的には、モデルを自由に調べられなかった大学などの研究者が不利を被った。一方で、偽情報や検出の研究者は限定共有のパートナーとして先に大型版を調べる機会を得た。段階的公開・研究パートナーとの限定共有・モデルカードの添付という手順は、その後の大型モデルの公開で繰り返し参照される形になった。
翌2020年の GPT-3 では、OpenAI は重みを最後まで配らず、API の向こう側に置く方式を採った(GPT-3 を参照)。モデルを公開するか、クラウド越しに使わせるかという対立は、2023年の Llama をめぐって再び表面化する。報道によれば、OpenAI が GPT-2 以来となるオープンウェイトのモデル gpt-oss を Apache 2.0 ライセンスで出したのは、2025年8月5日である。
公開の是非をめぐる問いそのものは決着していない。ただ、「最初に作った組織が、出す前に社会への影響を測り、段階を踏む」という発想が具体的な手順として示されたのは、2019年の GPT-2 が最初の大きな事例だった。関連する出来事は AI の年表、組織は OpenAI、用語は 大規模言語モデル にある。
よくある質問
- GPT-2 はなぜ公開されなかったのですか。
- OpenAI が、偽ニュース記事の生成、なりすまし、SNS 向けの虐待的・偽造コンテンツやスパムの自動生成といった悪用を懸念したためです。2019年2月14日の発表では、データセット・学習コード・重みを出さず、小型版と論文だけを公開しました。OpenAI はこの判断を実験と呼んでいました。
- GPT-2 の全体が公開されたのはいつですか。
- 2019年11月5日です。それまでに5月に355M 版、8月20日に774M 版が段階的に公開され、最終段で15億パラメータ版の重みとコード、出力を見分ける検出モデル、モデルカードが公開されました。
- 公開見送りにはどんな批判がありましたか。
- Georgetown 大学 CSET の Helen Toner によると、機械学習の研究者の多くは話題づくりだと受け止め、再現や検証を難しくして学術の開放性を損なうと批判しました。一方、AI 政策・ガバナンスの関係者はおおむね、悪用されうる研究の公開規範づくりを始めたことを評価しました。
- その後 OpenAI はモデルを公開するようになったのですか。
- 2020年の GPT-3 では重みを公開せず API で提供しました。報道によれば、GPT-2 以来となる OpenAI のオープンウェイトの言語モデル gpt-oss が出たのは2025年8月5日です。
出典
15億パラメータ・40GB・800万ページ、Reddit 3カルマの選別、学習済みモデルを公開しない理由、想定した悪用4例、実験という位置づけ、5月の中間更新(345M 版公開と762M・1.5B 版の限定共有)
一次資料GPT-2: 6-Month Follow-Up — OpenAI, Aug 20, 2019 (archived copy)
774M 版公開、5つを超える再現グループ、4つの研究パートナー、72%対83%の信頼性調査、検出精度は90%台前半〜半ば
一次資料GPT-2: 1.5B Release — OpenAI, Nov 5, 2019 (archived copy)
1.5B 版の公開、信頼性スコア6.91/6.72/6.07、検出率約95%、悪用の強い証拠はまだない、CTEC の過激派分析、モデルカード
研究者の批判と政策関係者の評価、段階的公開の経過、Connor Leahy の再現と公開撤回
最終更新: