T1#research
チューリングテスト ── 「機械は考えられるか」を模倣ゲームに置き換えた論文
メタデータ
- 日付
- 年代
- 1950s
- Tier
- T1
- 参照年表
- IT全史 ── 計算機が世界を編み変える · AIの歴史
- 出典数
- 05
- 関連項目
- 02
- Tags
- #research
チューリングテストとは、Alan Turing が1950年10月、英国の哲学誌 Mind(第59巻236号、433〜460ページ)に発表した論文「Computing Machinery and Intelligence」で提案した、機械の知能をめぐる判定法である。Turing は「機械は考えられるか」という問いに正面から答えず、質問者が文字だけのやり取りで相手を見分けられるかという模倣ゲーム(imitation game)に問いを置き換えた。今日「チューリングテスト」と呼ばれるのはこのゲームである。
この論文は、よく引かれる一場面よりずっと広い。テストの設計、50年後についての具体的な予言、9つの反論への応答、そして「学習する機械」の構想までを一続きに論じている。以下では、論文が実際に書いていることと、後世が付け加えた解釈とを分けて見ていく。Turing の生涯そのものは アラン・チューリング のページにある。
問いの置き換え ── 模倣ゲームの設定
論文の第1節は、問いを考えたいという一文で始まる。英語原文は "I propose to consider the question, "Can machines think?"" である。Turing はすぐに、「機械」と「考える」の意味を普段の用法から決めようとすれば、答えはギャラップ調査のような統計で探すことになり、それは不合理だと退ける。
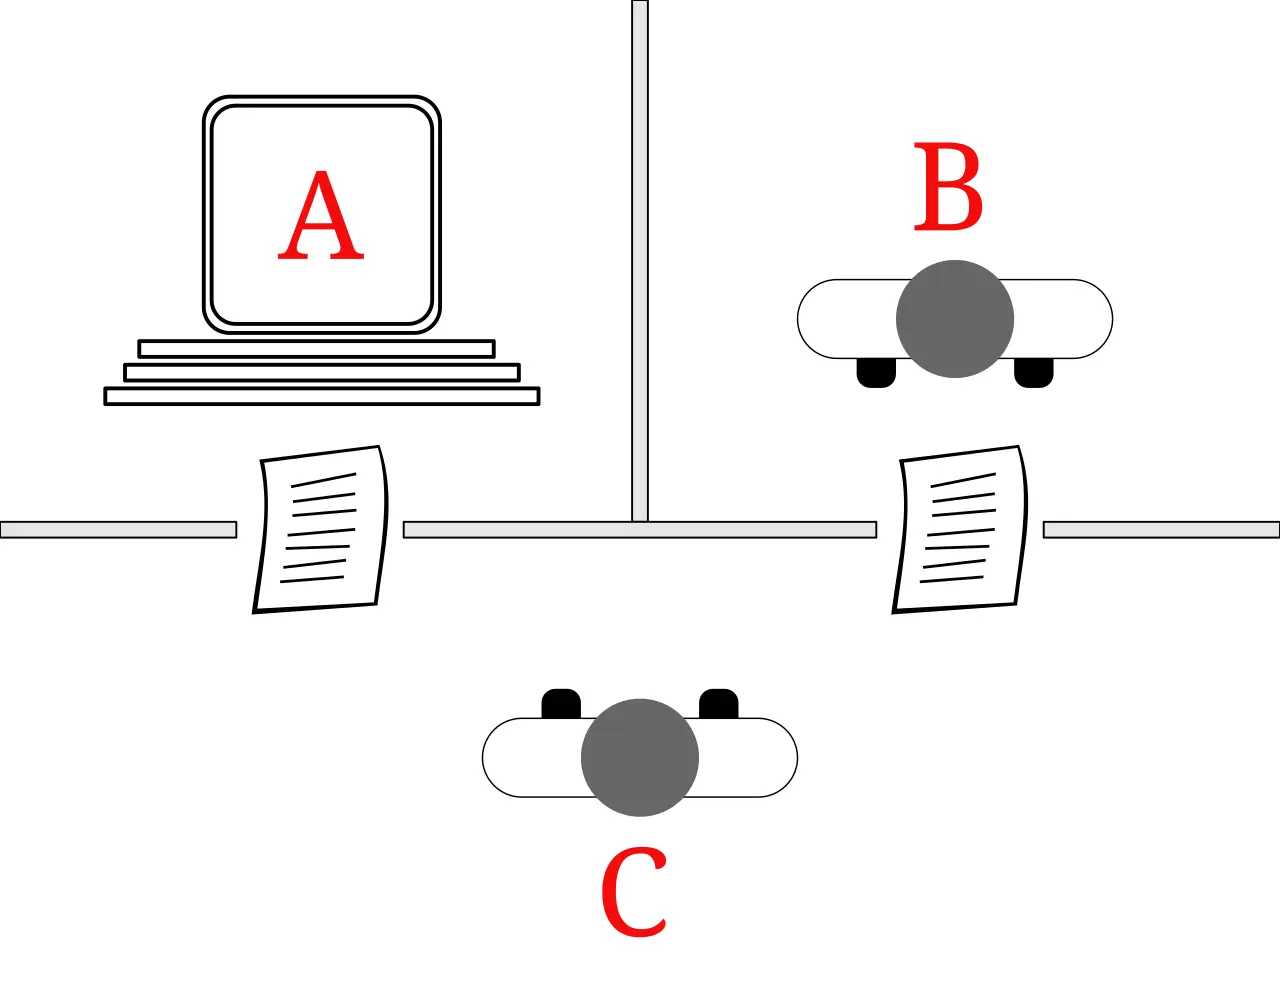
代わりに示されるのが3人で遊ぶゲームである。男性 A、女性 B、性別を問わない質問者 C がいて、C は別室から2人に質問し、どちらが男性でどちらが女性かを当てる。A の目的は C を誤らせることで、B の目的は C を助けることである。声の調子が手がかりにならないよう、答えは書いて、できればテレプリンターでやり取りする。
そのうえで Turing は問う。この A の役を機械が務めたら何が起きるか。人間の男女で遊ぶときと同じくらい、質問者は判断を誤るか。論文はこの問いが元の「機械は考えられるか」に置き換わると明記している。つまり原典のテストは、人間と機械を直接並べる形ではなく、男女の判別ゲームで機械が人間の代わりを務められるかという形で書かれている。
1950年の予言
第6節で Turing は自分の見通しを率直に書いている。
| 項目 | 論文の記述 |
|---|---|
| 時期 | 約50年後 |
| 計算機の規模 | 記憶容量およそ10の9乗 |
| 判定時間 | 5分間の質問 |
| 基準 | 平均的な質問者が正しく見分ける確率が70%を超えない |
| 元の問いについて | 「機械は考えられるか」は議論に値しないほど無意味(原文 "too meaningless to deserve discussion") |
| 20世紀末の予想 | 語の用法と教養ある世論が変わり、機械が考えると言っても反論されなくなる |
ここで押さえておきたいのは、Turing が「合格」の線を定義したわけではないことである。70%と5分は、50年後の技術水準についての予想として書かれている。スタンフォード哲学百科事典(SEP)の項目も、Turing が提案したテストと、20世紀末についての個別の予言とを区別すべきだと強調している。
9つの反論
論文の中心部は、機械が考えるという見方への反論を9つ並べ、一つずつ応じる構成になっている。見出しは次のとおりである。
| 番号 | 反論 |
|---|---|
| 1 | 神学的反論 |
| 2 | 「砂に頭を埋める」反論 |
| 3 | 数学的反論 |
| 4 | 意識からの議論 |
| 5 | さまざまな能力欠如からの議論 |
| 6 | ラヴレス夫人の反論 |
| 7 | 神経系の連続性からの議論 |
| 8 | 振る舞いの非形式性からの議論 |
| 9 | 超感覚的知覚からの議論 |
6番目は、Babbage の解析機関について Ada Lovelace が1842年の覚え書きに書いた言葉を取り上げる。Turing が引く原文は "The Analytical Engine has no pretensions to originate anything. It can do whatever we know how to order it to perform" で、機械は命じられたことしかできないという見方の代表として扱われている。Turing はこの反論への答えを、最後の節で学習の問題として引き取る。
学習する機械という結び
第7節「学習する機械」で Turing は、大人の心を模したプログラムを最初から作るのではなく、子どもの心を模したものを作って教育すればよいのではないかと提案する。子どもの脳は文房具店で買うノートのように、仕組みは少なく白紙が多いのではないか、という比喩も添えている。どの分野から始めるべきかについては、チェスのような抽象的な活動と、感覚器を備えて言葉を教える道の両方を試すべきだとした。
論文の最後の一文は "We can only see a short distance ahead, but we can see plenty there that needs to be done." である。学習によって振る舞いを獲得するという考えは、9年後に IBM の Arthur Samuel が チェッカーの研究 で実地に試すことになる。
「合格」の主張と、その評価
1950年以降、テストを実際に行う試みは何度もあった。主な主張と評価を並べる。
| 年 | 出来事 | 主張と評価 |
|---|---|---|
| 毎年開催 | Loebner 賞 | SEP は、20世紀末の時点で参加プログラムは Turing の想定にまったく届かず、平凡な質問で見破られたと評する |
| 1991年 | PC Therapist | SEP によれば審査員の50%を欺いたが、小規模な一回限りの試行 |
| 2014年6月7日 | Eugene Goostman(Turing Test 2014、ロンドンの王立協会) | 主催のレディング大学は、審査員30人の33%を欺き、30%超という基準で初めて合格したと発表 |
| 2025年3月 | Jones・Bergen の研究 | 人間らしい人格を指示された GPT-4.5 が73%の割合で人間と判定されたと報告 |
Eugene Goostman は13歳の少年を装うプログラムで、ロシア生まれの Vladimir Veselov らが開発した。大学の発表で Kevin Warwick は、同時比較の数が過去最多で、独立に検証され、会話の話題も制限しなかったと説明している。一方 SEP は、PC Therapist、2011年の Cleverbot、Eugene Goostman のいずれも試行の規模が小さく、平均的な質問者の正答率が70%以下だと考える強い根拠はないと指摘する。30%という基準も、論文では予言の数字であって合格の定義ではない。
2025年の研究は、Cameron R. Jones と Benjamin K. Bergen が arXiv に公開したもので、事前登録した無作為化試験として、参加者が人間1人と AI 1体と同時に5分間会話し、どちらが人間かを判定する3者形式をとった。LLaMa-3.1 は56%、比較用の ELIZA は23%、GPT-4o は21%だった。著者らは、どの人工システムであれ標準的な3者形式のチューリングテストに合格した初めての実証的証拠だと主張している。これは著者自身の評価であり、何をもって「標準的」とするかには議論の余地がある。
社会にとって何を意味したか
チューリングテストは、AI 研究の目標というより、知能を外から観察できる振る舞いで論じるための枠組みとして影響を残した。SEP は、Loebner 賞の参加者が年間最優秀の小さな賞を取るためだけに設計され、本当に会話できる機械を目指していなかったことが広く認められていたと書いており、テストが研究の物差しとして機能しなかった面も記録されている。
一方、人間と見分けのつかない会話が可能になることの意味は、2014年の時点で主催者自身が口にしていた。Warwick は大学の発表で、人を欺いて相手が人間だと信じさせる計算機は "a wake-up call to cybercrime" だと述べている。Jones と Bergen も、自分たちの結果は大規模言語モデルが示す知能の種類をめぐる議論と、こうしたシステムがもたらしうる社会的・経済的影響に関わると書いた。会話の相手が人間かどうかが分からないという問題は、ChatGPT の公開 以後、テストの外で日常の問題になっている。
よくある質問
- チューリングテストとは何ですか。
- Alan Turing が1950年の論文で提案した、機械の知能をめぐる判定法です。質問者が文字だけのやり取りで2人の回答者に質問し、どちらがどちらかを当てるゲームで、回答者の一方を機械に置き換えたとき、質問者が人間同士のときと同じくらい間違えるかを問います。Turing 自身は模倣ゲームと呼びました。
- チューリングテストはいつ、どこで発表されたのですか。
- 1950年10月、英国の哲学誌 Mind の第59巻236号(433〜460ページ)に載った論文「Computing Machinery and Intelligence」です。
- チューリングテストに合格した AI はありますか。
- 合格の主張は何度も出ています。2014年には主催したレディング大学が Eugene Goostman が審査員の33%を欺いて初めて合格したと発表し、2025年には GPT-4.5 が73%の割合で人間と判定されたとする研究が出ました。ただし前者は審査員30人の小規模な試行で、スタンフォード哲学百科事典は Turing の予言を満たしたと言える強い根拠はないと評しています。
- Turing はチューリングテストについて何を予言したのですか。
- 約50年後には、記憶容量10の9乗程度の計算機に模倣ゲームをうまく演じさせ、平均的な質問者が5分間の質問の後に正しく見分ける確率を70%以下にできると書きました。同時に、元の問い「機械は考えられるか」は議論に値しないほど無意味だとも述べています。
出典
論文の正本。巻号・ページ・発行月(自動取得は403、書誌は出版社ページで確認)
一次資料Computing Machinery and Intelligence — full-text transcription (UMBC course copy)
本文の逐語確認に使用。冒頭の問い、模倣ゲームの設定、50年後の予言、9つの反論、Lovelace の引用、学習する機械、結びの一文
Loebner 賞の評価、1991年 PC Therapist・2011年 Cleverbot・2014年 Eugene Goostman の試行が小規模で予言の基準を満たした根拠にならないという指摘、テストと予言の区別
一次資料Turing Test success marks milestone in computing history — University of Reading, 8 June 2014
Eugene Goostman の発表。審査員30人の33%、30%超を合格とする基準、Kevin Warwick のコメント
3者形式の事前登録試験。GPT-4.5 73%、LLaMa-3.1 56%、ELIZA 23%、GPT-4o 21%
最終更新: