T1#research
LeNet ── 郵便番号と小切手を読んだ畳み込みニューラルネットワーク
メタデータ
- 日付
- 年代
- 1980s
- Tier
- T1
- 参照年表
- AIの歴史
- 出典数
- 04
- 関連項目
- 05
- Tags
- #research
LeNet は、Yann LeCun らが AT&T ベル研究所で開発した畳み込みニューラルネットワーク(CNN)の系列の呼び名である。出発点は、LeCun、Bernhard Boser、John S. Denker ら7人が1989年12月の Neural Computation(1巻4号、541〜551ページ)に発表した論文「Backpropagation Applied to Handwritten Zip Code Recognition」で、米国郵便の封筒に手書きされた郵便番号の数字を、画像から直接読み取るネットワークを 誤差逆伝播法 で学習させた。よく知られた LeNet-5 は1998年11月の Proceedings of the IEEE の論文で詳しく説明され、この系統の技術を使った小切手読み取りシステムは、論文によれば米国の複数の銀行で使われた。ACM は2019年、LeCun を手書き数字の画像で CNN を初めて学習させた人物として、チューリング賞の授賞理由に挙げている。
1989年の論文 ── 郵便番号を読む
1989年の論文の要旨は、学習するネットワークの汎化能力は、課題の領域からの制約を与えることで大きく高められると述べ、その制約をネットワークの構造に組み込む方法を示したとする。対象は米国郵便公社から提供された手書きの郵便番号で、1つのネットワークが、正規化された文字画像から最終的な分類まで、認識の全工程を学習した。
| 項目 | 内容 |
|---|---|
| 著者 | Y. LeCun、B. Boser、J. S. Denker、D. Henderson、R. E. Howard、W. Hubbard、L. D. Jackel(AT&T ベル研究所、ニュージャージー州ホルムデル) |
| 掲載 | Neural Computation 1巻4号、541〜551ページ(1989年12月) |
| データ | ニューヨーク州バッファロー郵便局を通った郵便物の郵便番号から切り出した数字9,298個(学習7,291、テスト2,007) |
| 入力 | 16×16画素に正規化した画像 |
| 規模 | ユニット1,256、結合64,660、独立パラメータ9,760 |
| 結果 | テスト誤り率5.0%(102個)。誤り率を1%に抑えるには12.1%を棄却 |
| 学習 | SUN-4/260 上で23周、約3日 |
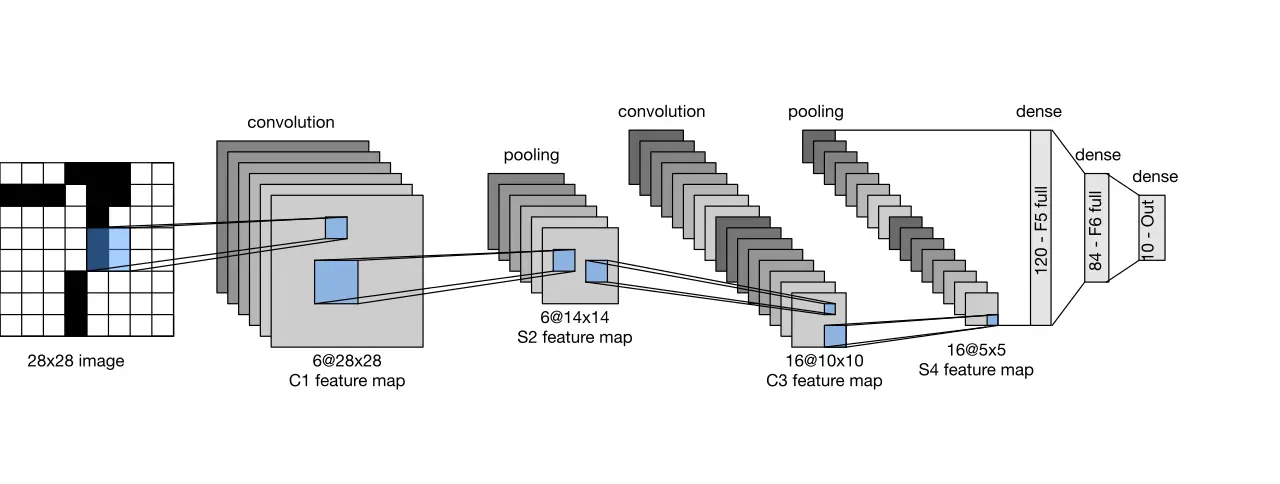
工夫の中心は「重み共有」と「特徴マップ」だった。画像のどこに現れても同じ特徴(線の端や角など)を見つけられるよう、同じ重みを持つ小さな検出器を画像全体に並べる。こうして自由に動かせるパラメータの数を大きく減らしながら、結合の数は多く保った。論文は、全結合のネットワークを試すと汎化性能がかなり悪かったと書き、学習した検出器の一部が生物の視覚系で見つかっている特徴検出器とよく似ていたとも記している。
封筒から郵便番号を見つけて1文字ずつ切り出す工程は、郵便公社の委託業者が行っていた。論文はさらに、市販の DSP ボードを PC につないだ実装で、カメラで取り込んだ画像を毎秒10〜12文字の速さで認識できたと報告している。
LeNet-5 と MNIST(1998年)
1998年、LeCun、Léon Bottou、Yoshua Bengio、Patrick Haffner は Proceedings of the IEEE(86巻11号、2278〜2324ページ)に「Gradient-Based Learning Applied to Document Recognition」を発表した。ここで説明された LeNet-5 は、入力を除いて7層からなり、論文によれば結合は34万5,308本あるが、重み共有によって学習するパラメータは6万個にとどまる。
| 項目 | 内容 |
|---|---|
| データ | MNIST(学習用6万枚、実験で使ったテスト1万枚) |
| テスト誤り率 | 0.95%。変形を加えた画像で学習すると0.8% |
| データの出所 | 米国標準技術研究所(NIST)の2つのデータベースを混ぜて再構成 |
この論文で作られた MNIST(Modified NIST)データセットの成り立ちは、学習データの性質が結果を左右することを示す例でもある。論文によれば、NIST が学習用とした Special Database 3 は国勢調査局の職員から、テスト用とした Special Database 1 は高校生から集めたもので、前者のほうがずっときれいで読みやすかった。どちらで学習しテストするかに結論が左右されないよう、LeCun らは2つを混ぜてデータを作り直した。誰の書いた文字で学習したかが機械の得意・不得意を決める、という問題は、のちの顔認識や言語モデルで社会的な争点になる。
銀行の小切手を読む
1998年の論文は、小切手の金額欄を読むシステムも説明している。要旨は、それが商用に配備され、1日に数百万枚の小切手を読んでいると書く。本文の別の箇所は、このシステムが NCR 社の銀行向け小切手認識装置に組み込まれ、1996年6月から米国の複数の銀行で使われていると説明する。ただし同じ論文の序論には「月に数百万枚」という表現もあり、規模の数字は論文の中でも揃っていない。いずれも開発者自身による説明である。
論文によれば、1995年にシステムインテグレーターが行った独立の試験で、このシステムは他の市販の金額読み取りシステムより優れていた。つまり LeNet は、まったく人手だった作業をいきなり置き換えたのではなく、すでにあった自動読み取りの精度を上げる形で銀行業務に入った。どれだけの人手作業が減ったかを示す数字は、論文には書かれていない。ACM は2019年のチューリング賞の発表で、Bengio の業績として、隠れマルコフモデルとニューラルネットワークを組み合わせた考え方が AT&T と NCR の手書き小切手読み取りシステムに使われたことも挙げている。
その後
ACM の発表文によれば、CNN は今日、画像認識の業界標準であり、音声認識・音声合成・画像生成・自然言語処理にも使われ、自動運転、医療画像の解析、音声アシスタント、情報のフィルタリングなど幅広い用途を持つ。1998年の論文は結論で、学習の役割を増やすたびに認識システムの性能は上がってきたとし、CNN によって手作りの特徴抽出器が不要になったと書いた。
ただし、LeNet から深層学習の時代までは一直線ではなかった。CNN が画像認識の主流になったことを広く印象づけたのは、GPU と大規模データを使った2012年の AlexNet で、その学習データとなった ImageNet の構築もその前提にあった。LeNet の重み共有と畳み込みという構造は、そこにそのまま受け継がれている。LeCun は AI のリスクをめぐって、ともにチューリング賞を受けた Hinton と異なる立場を取ってきた(Hinton の Google 退社 を参照)。
よくある質問
- LeNet とは何ですか。
- AT&T ベル研究所の Yann LeCun らが開発した畳み込みニューラルネットワークの系列です。1989年の論文で米国郵便の手書き郵便番号を読み取り、1998年の論文で LeNet-5 が詳しく説明されました。
- 1989年の LeNet の精度はどれくらいでしたか。
- 2,007個のテスト用数字で誤り率5.0%(102個)でした。誤り率を1%に抑えるには、12.1%の数字を判定保留にする必要がありました。
- LeNet は実際に使われたのですか。
- 1998年の論文によれば、この技術を使った小切手の金額読み取りシステムが NCR の製品に組み込まれ、1996年6月から米国の複数の銀行で使われました。要旨は1日に数百万枚を読むとしていますが、序論には月に数百万枚という表現もあり、数字は論文の中でも揃っていません。
- MNIST とは何ですか。
- 1998年の論文で LeCun らが、米国標準技術研究所(NIST)の2つの手書き数字データベースを混ぜて作り直したデータセットです。学習用6万枚からなり、論文ではテスト1万枚を使いました。元のデータは国勢調査局の職員と高校生から集められたものでした。
出典
要旨、バッファロー郵便局の9,298個の数字、ネットワークの規模、テスト誤り率5.0%と棄却率12.1%、SUN-4/260 と約3日の学習、生物の視覚との類似、DSP 実装
LeNet-5 の構成と6万個のパラメータ、MNIST の作り方と出所、誤り率0.95%と0.8%、NCR への組み込みと1996年6月からの銀行での使用、要旨と序論で異なる処理枚数
一次資料Fathers of the Deep Learning Revolution Receive ACM A.M. Turing Award — ACM, Mar 27, 2019
LeCun が手書き数字の画像で CNN を初めて学習させたという ACM の評価、CNN の用途、Bengio の業績と AT&T・NCR の小切手読み取り
最終更新: