T1#research
深層信念ネットワーク ── 2006年、深いニューラルネットが再び学習できた
メタデータ
- 日付
- 年代
- 2000s
- Tier
- T1
- 参照年表
- AIの歴史
- 出典数
- 07
- 関連項目
- 06
- Tags
- #research
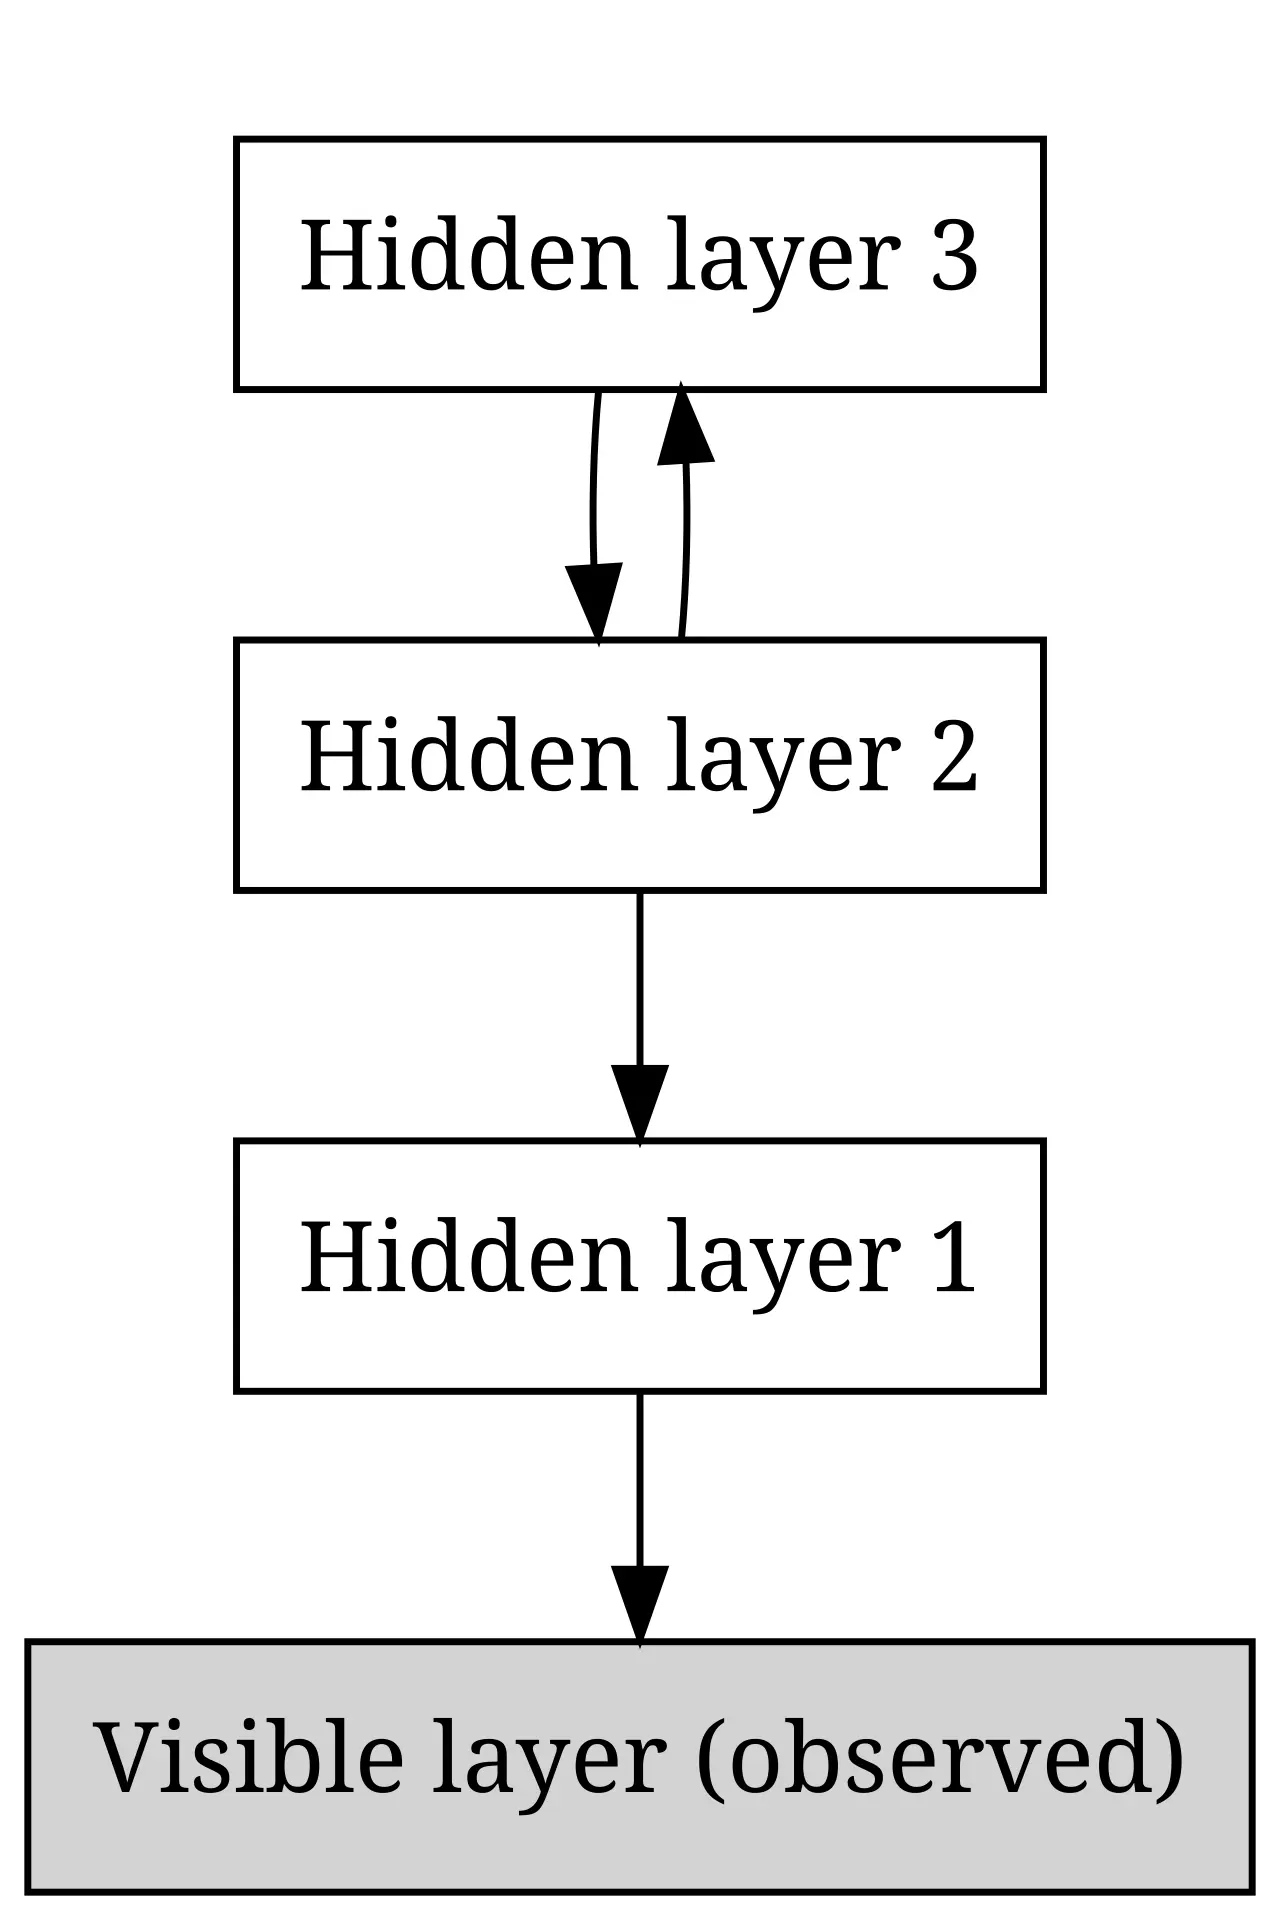
深層信念ネットワーク(deep belief net, DBN)は、Geoffrey Hinton、Simon Osindero、Yee-Whye Teh が2006年7月の Neural Computation 誌(18巻7号)に発表した論文「A fast learning algorithm for deep belief nets」で提案した、隠れ層を何層も持つ生成モデルである。制限ボルツマンマシン(RBM)を1層ずつ学習させて積み上げる速い貪欲法を使い、それまで学習が難しかった深いネットワークを訓練できることを示した。同じ月の28日には、Hinton と Ruslan Salakhutdinov が Science 誌に、この事前学習を深い自己符号化器に応用した論文を載せた。2006年が「深層学習の再出発の年」と呼ばれるのは、主にこの2本の論文による。
背景 ── 見放されていたニューラルネット
2015年に Yann LeCun、Yoshua Bengio、Hinton の3人が Nature に書いた総説は、1990年代末の状況をこう振り返っている。ニューラルネットと誤差逆伝播法は機械学習の分野でほとんど見捨てられ、コンピュータビジョンや音声認識の分野では無視されていた。事前知識の少ない多段の特徴抽出器を学習させるのは無理だと広く考えられ、勾配降下法は悪い局所解に捕まると思われていた。
誤差逆伝播法そのものは1986年に Rumelhart・Hinton・Williams の論文で広まっていた(誤差逆伝播法)。問題は、層を深くすると学習がうまく進まないことだった。
2006年7月の2本の論文
| 項目 | Neural Computation 論文 | Science 論文 |
|---|---|---|
| 著者 | Hinton・Osindero(トロント大学)、Teh(シンガポール国立大学) | Hinton・Salakhutdinov(トロント大学) |
| 掲載 | 18巻7号、1527〜1554頁(2006年7月) | 313巻5786号、504〜507頁(2006年7月28日) |
| 中心となる考え | RBM を1層ずつ貪欲に学習して積み、最後に全体を微調整する | 同じ事前学習で深い自己符号化器を初期化し、誤差逆伝播法で微調整する |
| 主な結果 | MNIST の誤り率1.25% | 主成分分析(PCA)より良い低次元表現 |
Neural Computation 論文のモデルは、最上部の2層が無向の連想記憶になり、その下の層は有向の結合で画像の画素を生成する構成である。まず各層を RBM として下から順に学習させ、上の層は下の層の出力をデータとして学ぶ。論文は、層を加えるたびに生成モデル全体の変分下界が改善することを示した。そのあと「上下アルゴリズム」と呼ぶ方法で全体を微調整する。
手書き数字のデータセット MNIST(学習6万枚、テスト1万枚)で、3つの隠れ層と約170万個の重みを持つネットワークは、公式テストで誤り率1.25%を出した。論文は、手作りの工夫をしない誤差逆伝播法のネットワークの最良値1.5%や、サポートベクターマシンの1.4%より良いとしている。学習は3GHz の Xeon 上の Matlab で行い、層ごとの学習に数時間、全体で約1週間かかった。
Science 論文は、784画素の画像を30個の数に圧縮する深い自己符号化器を、同じ事前学習で初期化した。事前学習がないと、とても深い自己符号化器は学習を続けても訓練データの平均しか再現できなかった。事前学習をすると、PCA よりはるかに良い再構成ができ、80万件を超えるニュース記事の検索では潜在意味解析(LSA)を上回った。論文の結びは、深い自己符号化器が有効だろうということは1980年代から明らかだったが、それには計算機が十分に速く、データが十分に大きく、重みの初期値が良い解に十分近いことが必要で、今その3つの条件がそろったと述べている。
同じ2006年には、Bengio らの層ごとの貪欲学習の論文や、LeCun のグループの疎な表現の学習の論文も出た。Nature 総説は、これらをまとめて2006年ごろの復活の典拠に挙げている。
歴史の書かれ方 ── 2006年起点説と、その批判
Nature 総説は、深い順伝播型ネットワークへの関心は2006年ごろ、カナダ高等研究機構(CIFAR)が集めた研究者たちによって復活したと書く。最初の大きな応用は音声認識で、2009年に事前学習した深いネットが小語彙の標準ベンチマークで記録を出し、2012年には主要な音声認識グループが開発を進め、Android の電話に搭載され始めていたという。
これに強く反論したのが、スイス IDSIA の Jürgen Schmidhuber である。2015年6月の批判文で、この記述は著者たち自身の研究室だけを指しており誤解を招くと書き、2006年までに多くの研究者が Ivakhnenko 型の深いネットを何十年も使っていたと指摘した。また、自身の1990年代初めの「履歴圧縮器」による深い再帰型ネットワークの教師なし事前学習が、2006年以降の手法と発想も理由づけもよく似ていたと主張している。2006年を起点とする物語は、主に当事者の側から書かれたものであることは押さえておきたい。
その後と社会への影響
層ごとの事前学習そのものは、長くは主役の座にとどまらなかった。Nature 総説によれば、活性化関数に ReLU を使うと教師なしの事前学習なしで深いネットワークを学習できるようになり、深層学習が復権したあとは、事前学習が必要なのは小さなデータセットの場合だけだと分かった。2012年の画像認識の大勝は、GPU、ReLU、ドロップアウトなどによるもので、総説はこれがコンピュータビジョンに革命をもたらしたとしている(AlexNet)。
それでも2006年の論文は、研究者の関心と資金が深いネットワークに戻るきっかけになった。音声認識の改善はスマートフォンの利用者に直接届き、研究の主導権は特徴量を人が設計する手法から学習する手法へ移った。2019年3月27日、ACM は Bengio・Hinton・LeCun に2018年のチューリング賞を贈り、発表の見出しで3人を深層学習革命の父と呼んだ。発表によれば、Hinton は CIFAR の Neural Computation and Adaptive Perception プログラムの創設時の責任者だった。Hinton は2024年にノーベル物理学賞を受け(AI のノーベル賞)、その前年には AI のリスクを語るために Google を離れている(Hinton の Google 退社)。
人物については Geoffrey Hinton のページに、用語は 深層学習 と 教師なし学習 に、流れ全体は AI の年表 にある。
よくある質問
- 深層信念ネットワークとは何ですか。
- 隠れ層を何層も持つ確率的な生成モデルで、上の2層が無向の連想記憶、その下が有向の層になっています。2006年の Hinton・Osindero・Teh の論文は、制限ボルツマンマシンを1層ずつ学習させて積み上げる速い貪欲法でこれを学習できることを示しました。
- 2006年の論文はどんな成果を出したのですか。
- Neural Computation の論文は、手書き数字 MNIST の公式テストで誤り率1.25%を出し、手作りの工夫をしない誤差逆伝播法のネットワークの1.5%や、サポートベクターマシンの1.4%を下回りました。Science の論文は、事前学習した深い自己符号化器が主成分分析より良い圧縮表現を学ぶことを示しました。
- 2006年が深層学習の始まりなのですか。
- そう書く歴史は多く、2015年の LeCun・Bengio・Hinton の Nature 総説も、深いネットワークへの関心が2006年ごろ復活したとしています。ただし Schmidhuber は、それ以前から深いネットワークは使われており、この記述は自分たちの研究室だけを指していると批判しています。
- 層ごとの事前学習はいまも使われていますか。
- 標準ではなくなりました。2015年の Nature 総説は、ReLU を使えば教師なしの事前学習なしで深いネットワークを学習できるようになり、深層学習が復権した後は、事前学習が必要なのは小さなデータセットの場合だけだと分かったと書いています。
出典
相補的事前分布、層ごとの貪欲学習、上下アルゴリズムによる微調整、MNIST 誤り率1.25%(逆伝播1.5%、SVM 1.4%)、学習に約1週間
RBM の積み重ねによる事前学習と深い自己符号化器、PCA・LSA との比較、MNIST 1.2%、1980年代からの見通しと「3つの条件」
一次資料Deep learning — LeCun, Bengio & Hinton, Nature 521, 436–444 (May 28, 2015)
1990年代末の冷遇、2006年ごろ CIFAR が集めた研究者による復活、2009年の音声認識と2012年の Android への展開、ReLU と事前学習の不要化
2006年の復活という記述への反論、1990年代の履歴圧縮器による教師なし事前学習
一次資料Fathers of the Deep Learning Revolution Receive ACM A.M. Turing Award — ACM, Mar 27, 2019
Bengio・Hinton・LeCun の2018年チューリング賞、Hinton の CIFAR での役割
最終更新: